Jev: o modelo da TypeSafe que não conversa, decide
Repara numa coisa que você faz todo dia sem pensar. Quase toda chamada de IA dentro de um software funciona assim: você monta um prompt, pede para o modelo escrever alguma coisa, e depois escreve código para interpretar o que ele escreveu. Pede JSON, torce para vir JSON, valida, e ainda trata o caso em que veio um textinho antes da chave.
A TypeSafe AI olhou para esse desperdício e fez uma pergunta incômoda: e se boa parte dessas chamadas não precisasse de linguagem nenhuma?
Foi isso que eles lançaram em 14 de setembro de 2026: o Jev, o primeiro modelo público de uma categoria que a empresa chama de System One Models. A frase que resume a proposta é curta:
estado não estruturado na entrada, decisões probabilísticas tipadas na saída.
Antes de a gente continuar, um aviso de rigor que vale para o texto inteiro: o Jev tem poucos dias de vida, e quase tudo que se sabe sobre arquitetura e desempenho vem da própria TypeSafe. Trate os números como alegações do fabricante até aparecerem avaliações independentes. Você sabe que eu não gosto de vender peixe de ninguém.
De onde vem esse nome, System One
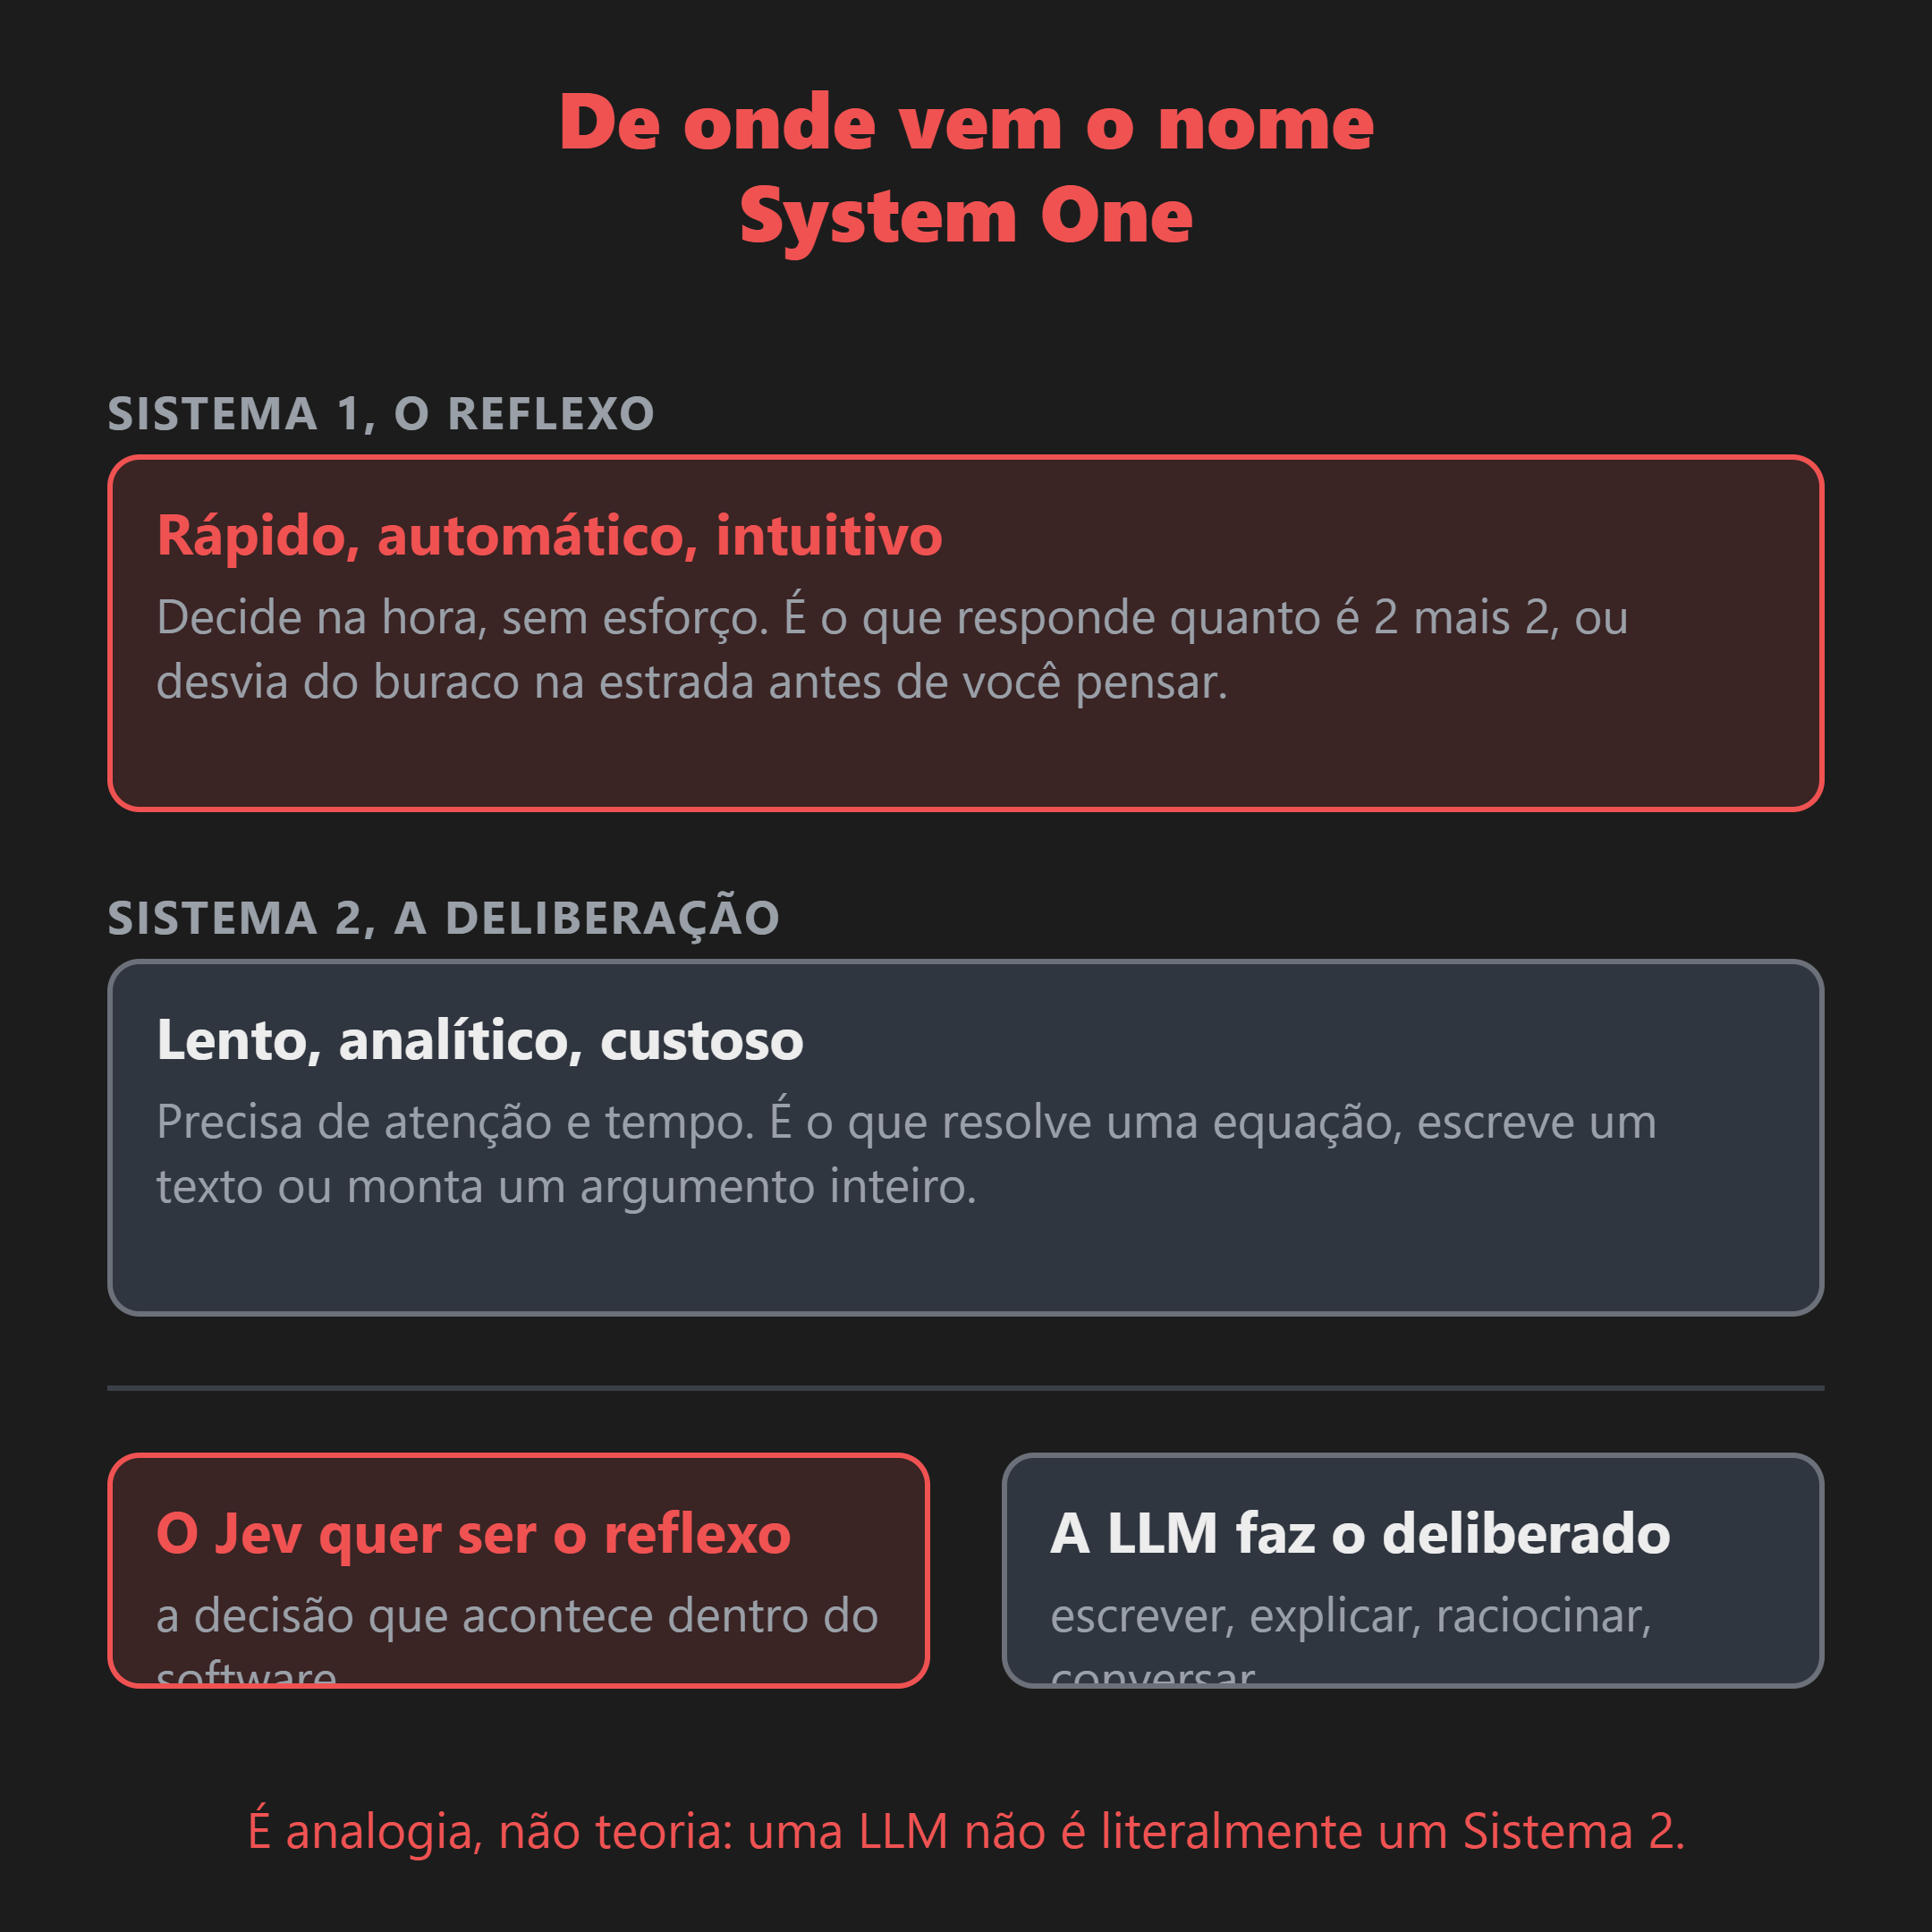
A inspiração é aquela distinção que o Daniel Kahneman popularizou no Rápido e Devagar: o Sistema 1 é rápido, automático, intuitivo, decide na hora; o Sistema 2 é lento, deliberado, analítico, custa esforço.
A TypeSafe usa isso como analogia para separar dois tipos de trabalho. Um LLM conversacional faz o trabalho deliberado: escreve, explica, raciocina, conversa. O Jev quer ser o reflexo, aquela decisão imediata que acontece dentro do software, milhares de vezes, sem ninguém lendo.
E repara que é analogia, inspiração conceitual. Um LLM não é literalmente um Sistema 2.
Gerar linguagem é uma coisa, tomar decisão é outra
Um LLM tradicional é autoregressivo: ele gera um token, depois o próximo, depois o próximo. Isso é poderosíssimo justamente porque a saída é aberta. Dá conversa, explicação, código, relatório, raciocínio.
Só que muitos sistemas não precisam de resposta em linguagem. Eles precisam saber:
A, B ou C?
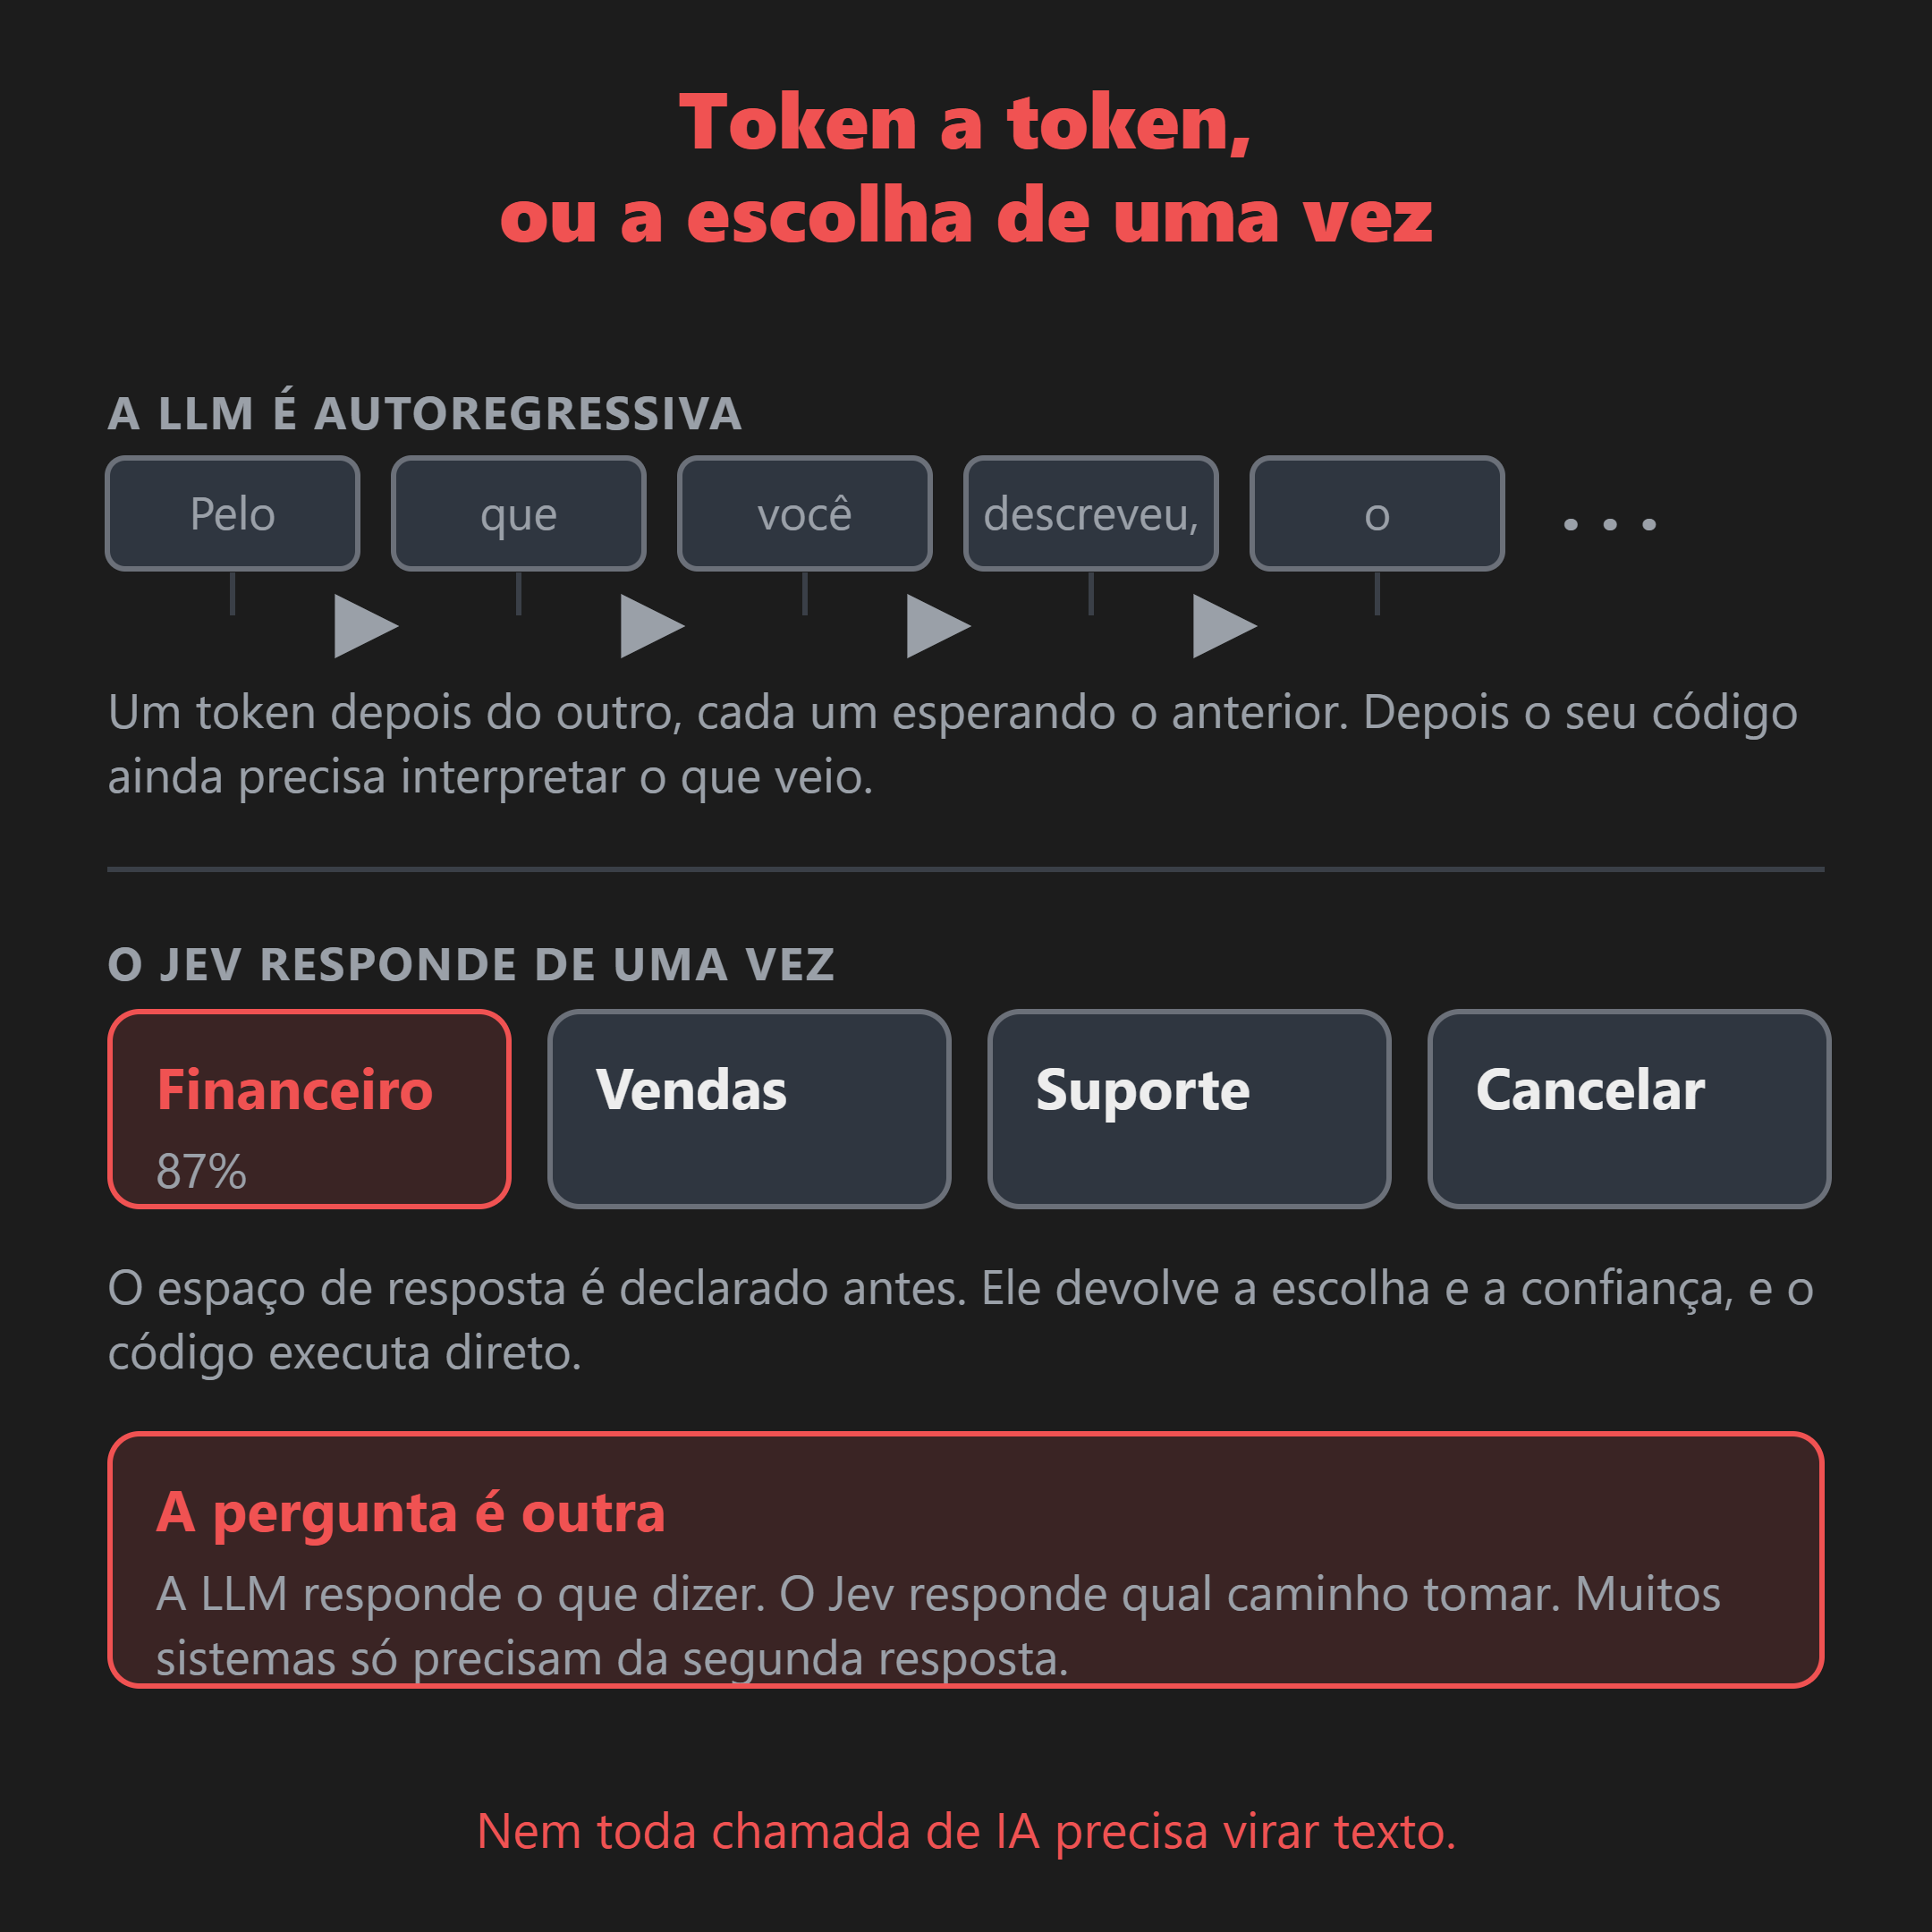
E o Jev foi feito para isso. Em vez de produzir um parágrafo que o software depois interpreta, o espaço de respostas é declarado antes, e o modelo devolve direto a decisão estruturada, com a probabilidade junto.
Um exemplo bem concreto
Um cliente escreve no chat:
Minha fatura veio duplicada este mês. Preciso resolver isso.
Antes de responder qualquer coisa, o sistema precisa decidir para onde mandar essa mensagem. E as opções já são conhecidas: Financeiro, Vendas, Suporte Técnico, Cancelamento.
O Jev recebe o estado, que aqui é a mensagem, mais a pergunta estruturada sobre qual rota escolher. Devolve Financeiro, com a confiança associada. E o código executa o roteamento.
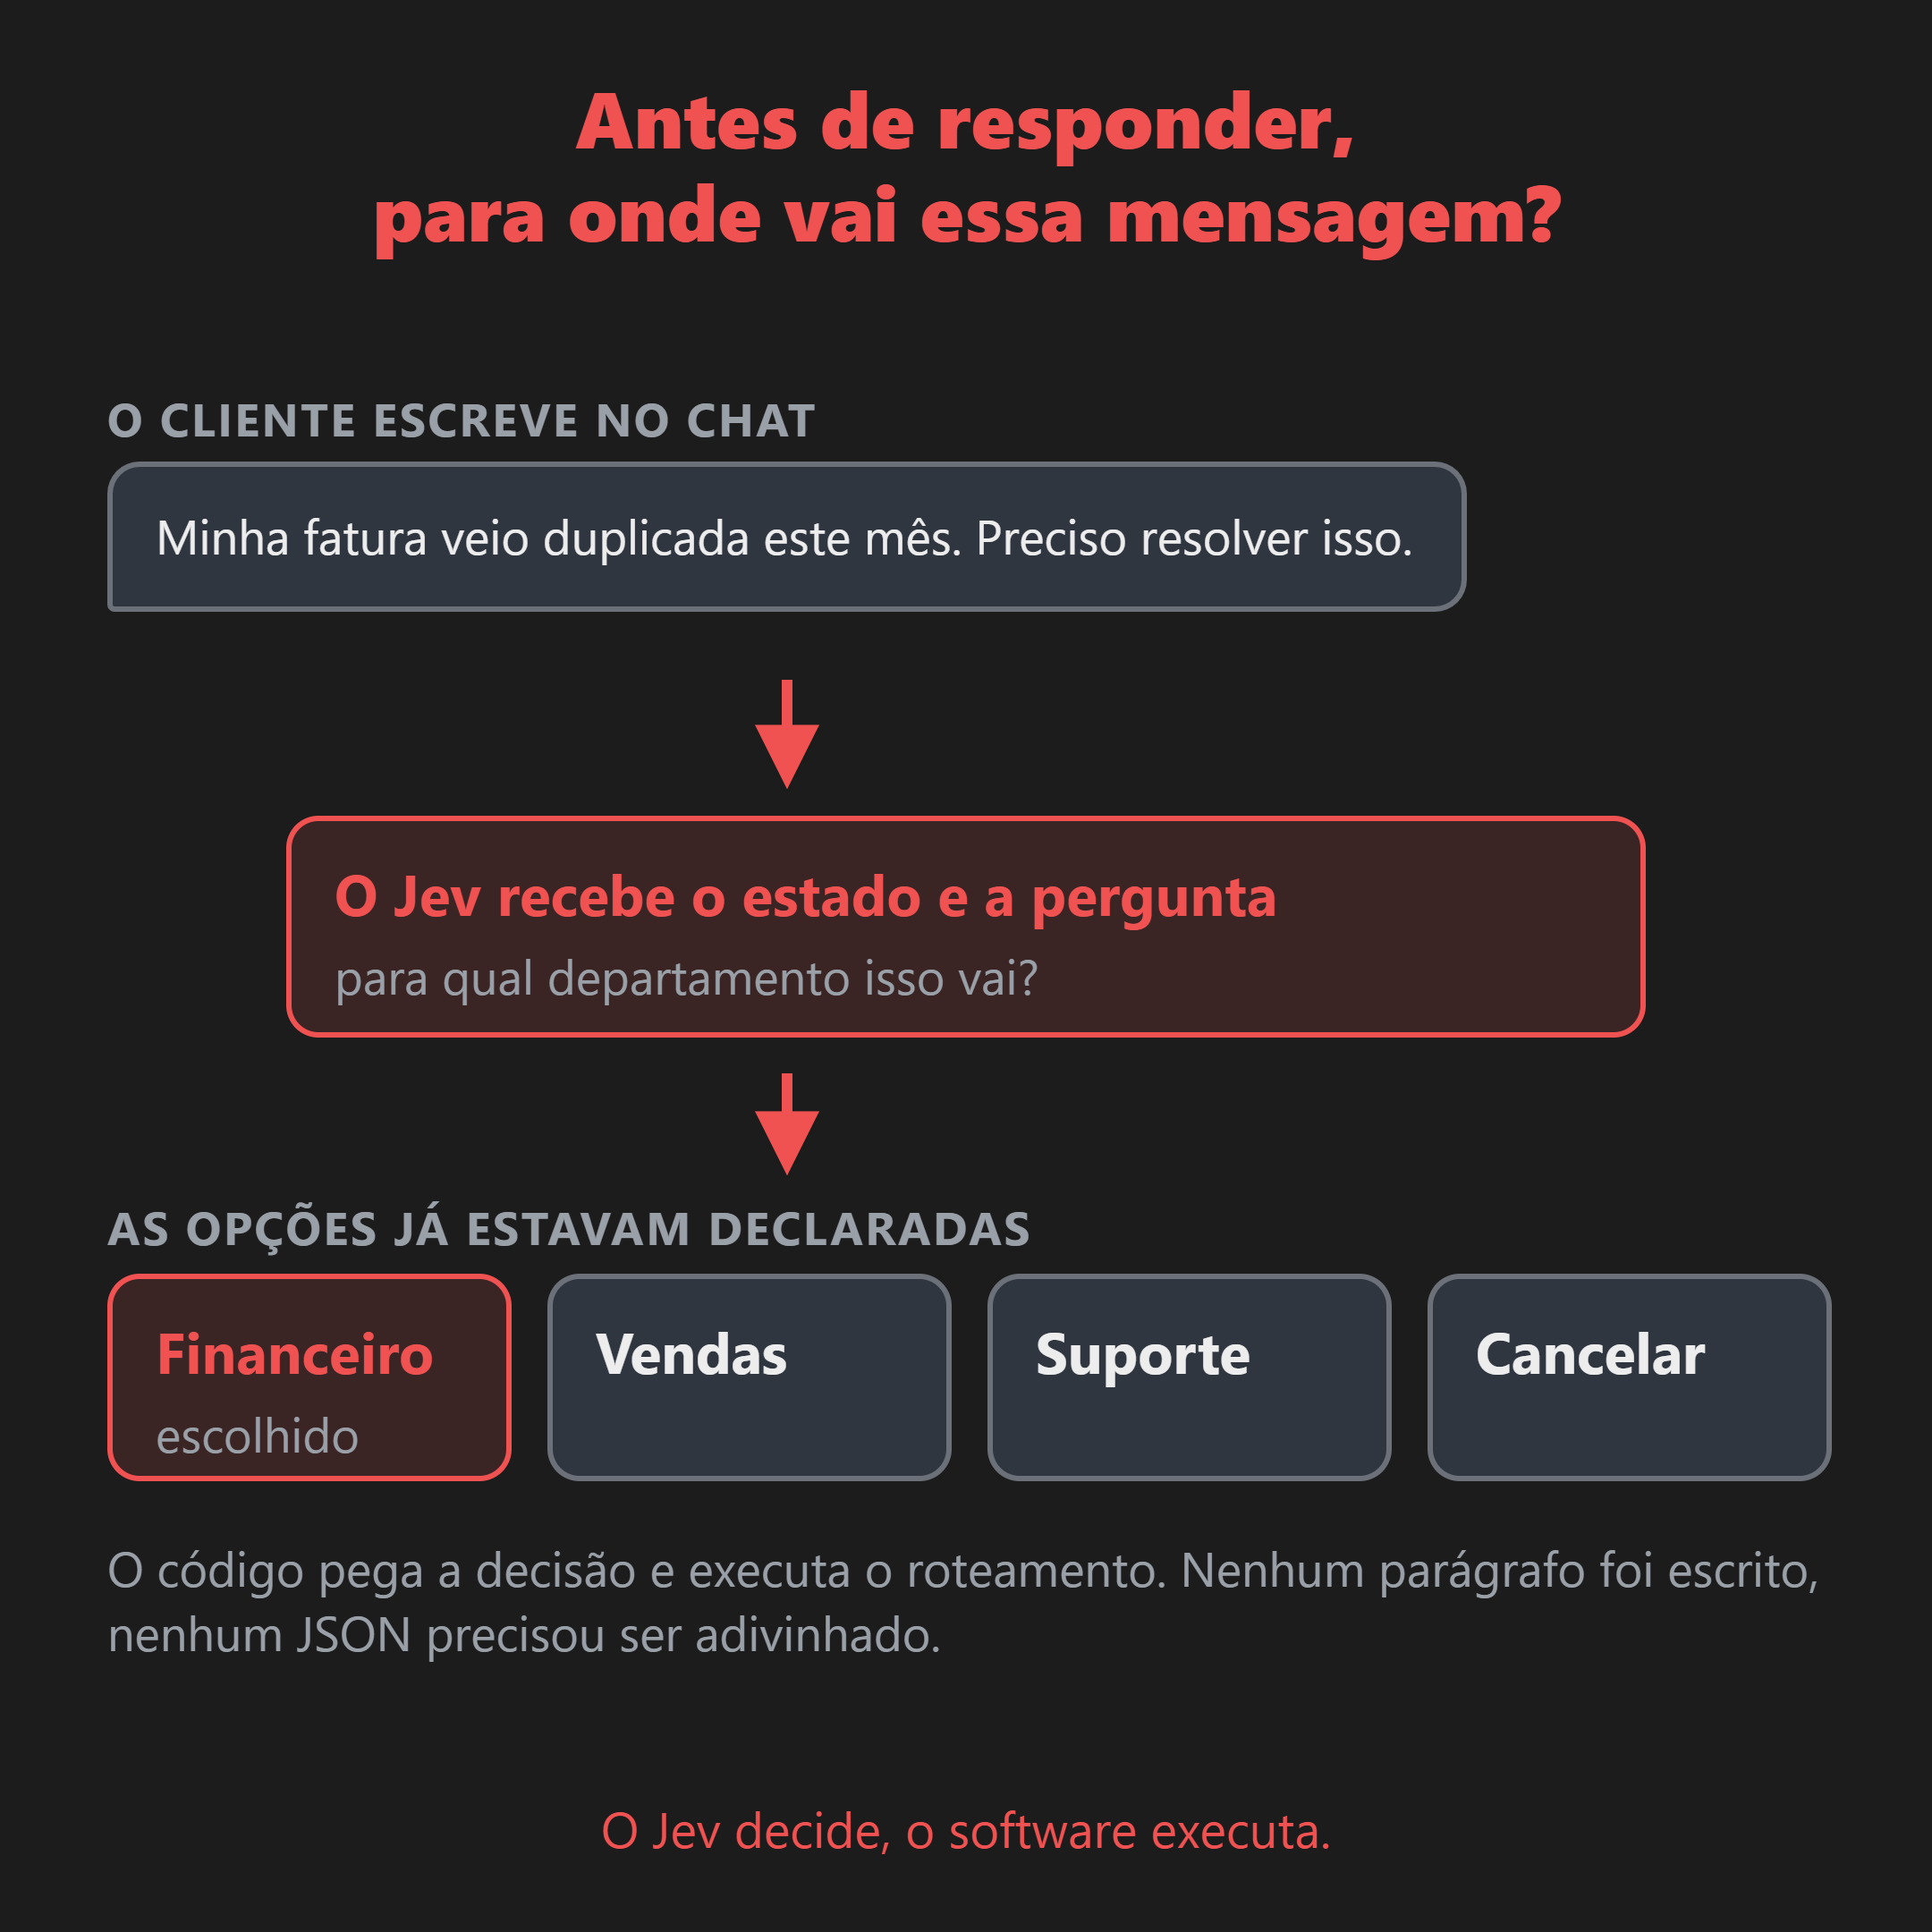
O fluxo conceitual é sempre esse:
estado, pergunta, tipo e opções, decisão com probabilidades
E quem define as opções é você, o desenvolvedor. Esse é o ponto que muda tudo: o software declara antecipadamente o que quer saber e a estrutura permitida para a resposta. O modelo escolhe dentro daquele espaço, não fora dele.
A TypeSafe posiciona o Jev para classificar, rotear, pontuar, extrair, escolher alternativas, criar branch em workflow, verificar, julgar e aplicar guardrails. Numa frase: transformar decisão semântica em if statement inteligente.
Agora olha onde isso fica interessante para quem trabalha com RAG
Imagina um RAG agêntico com bases vetoriais separadas: Direito, Medicina, Engenharia.
Chega a pergunta: qual é o prazo para recorrer desta decisão judicial?
Antes de recuperar um único documento, o agente precisa escolher em qual base buscar. Essa é exatamente aquela microdecisão que hoje te custa uma chamada inteira de LLM.
O desenho fica assim:
pergunta → Jev → DIREITO → vector DB de Direito → RAG → LLM → resposta
Cada peça com a sua responsabilidade:
O Jev decide. O RAG busca. O LLM responde.
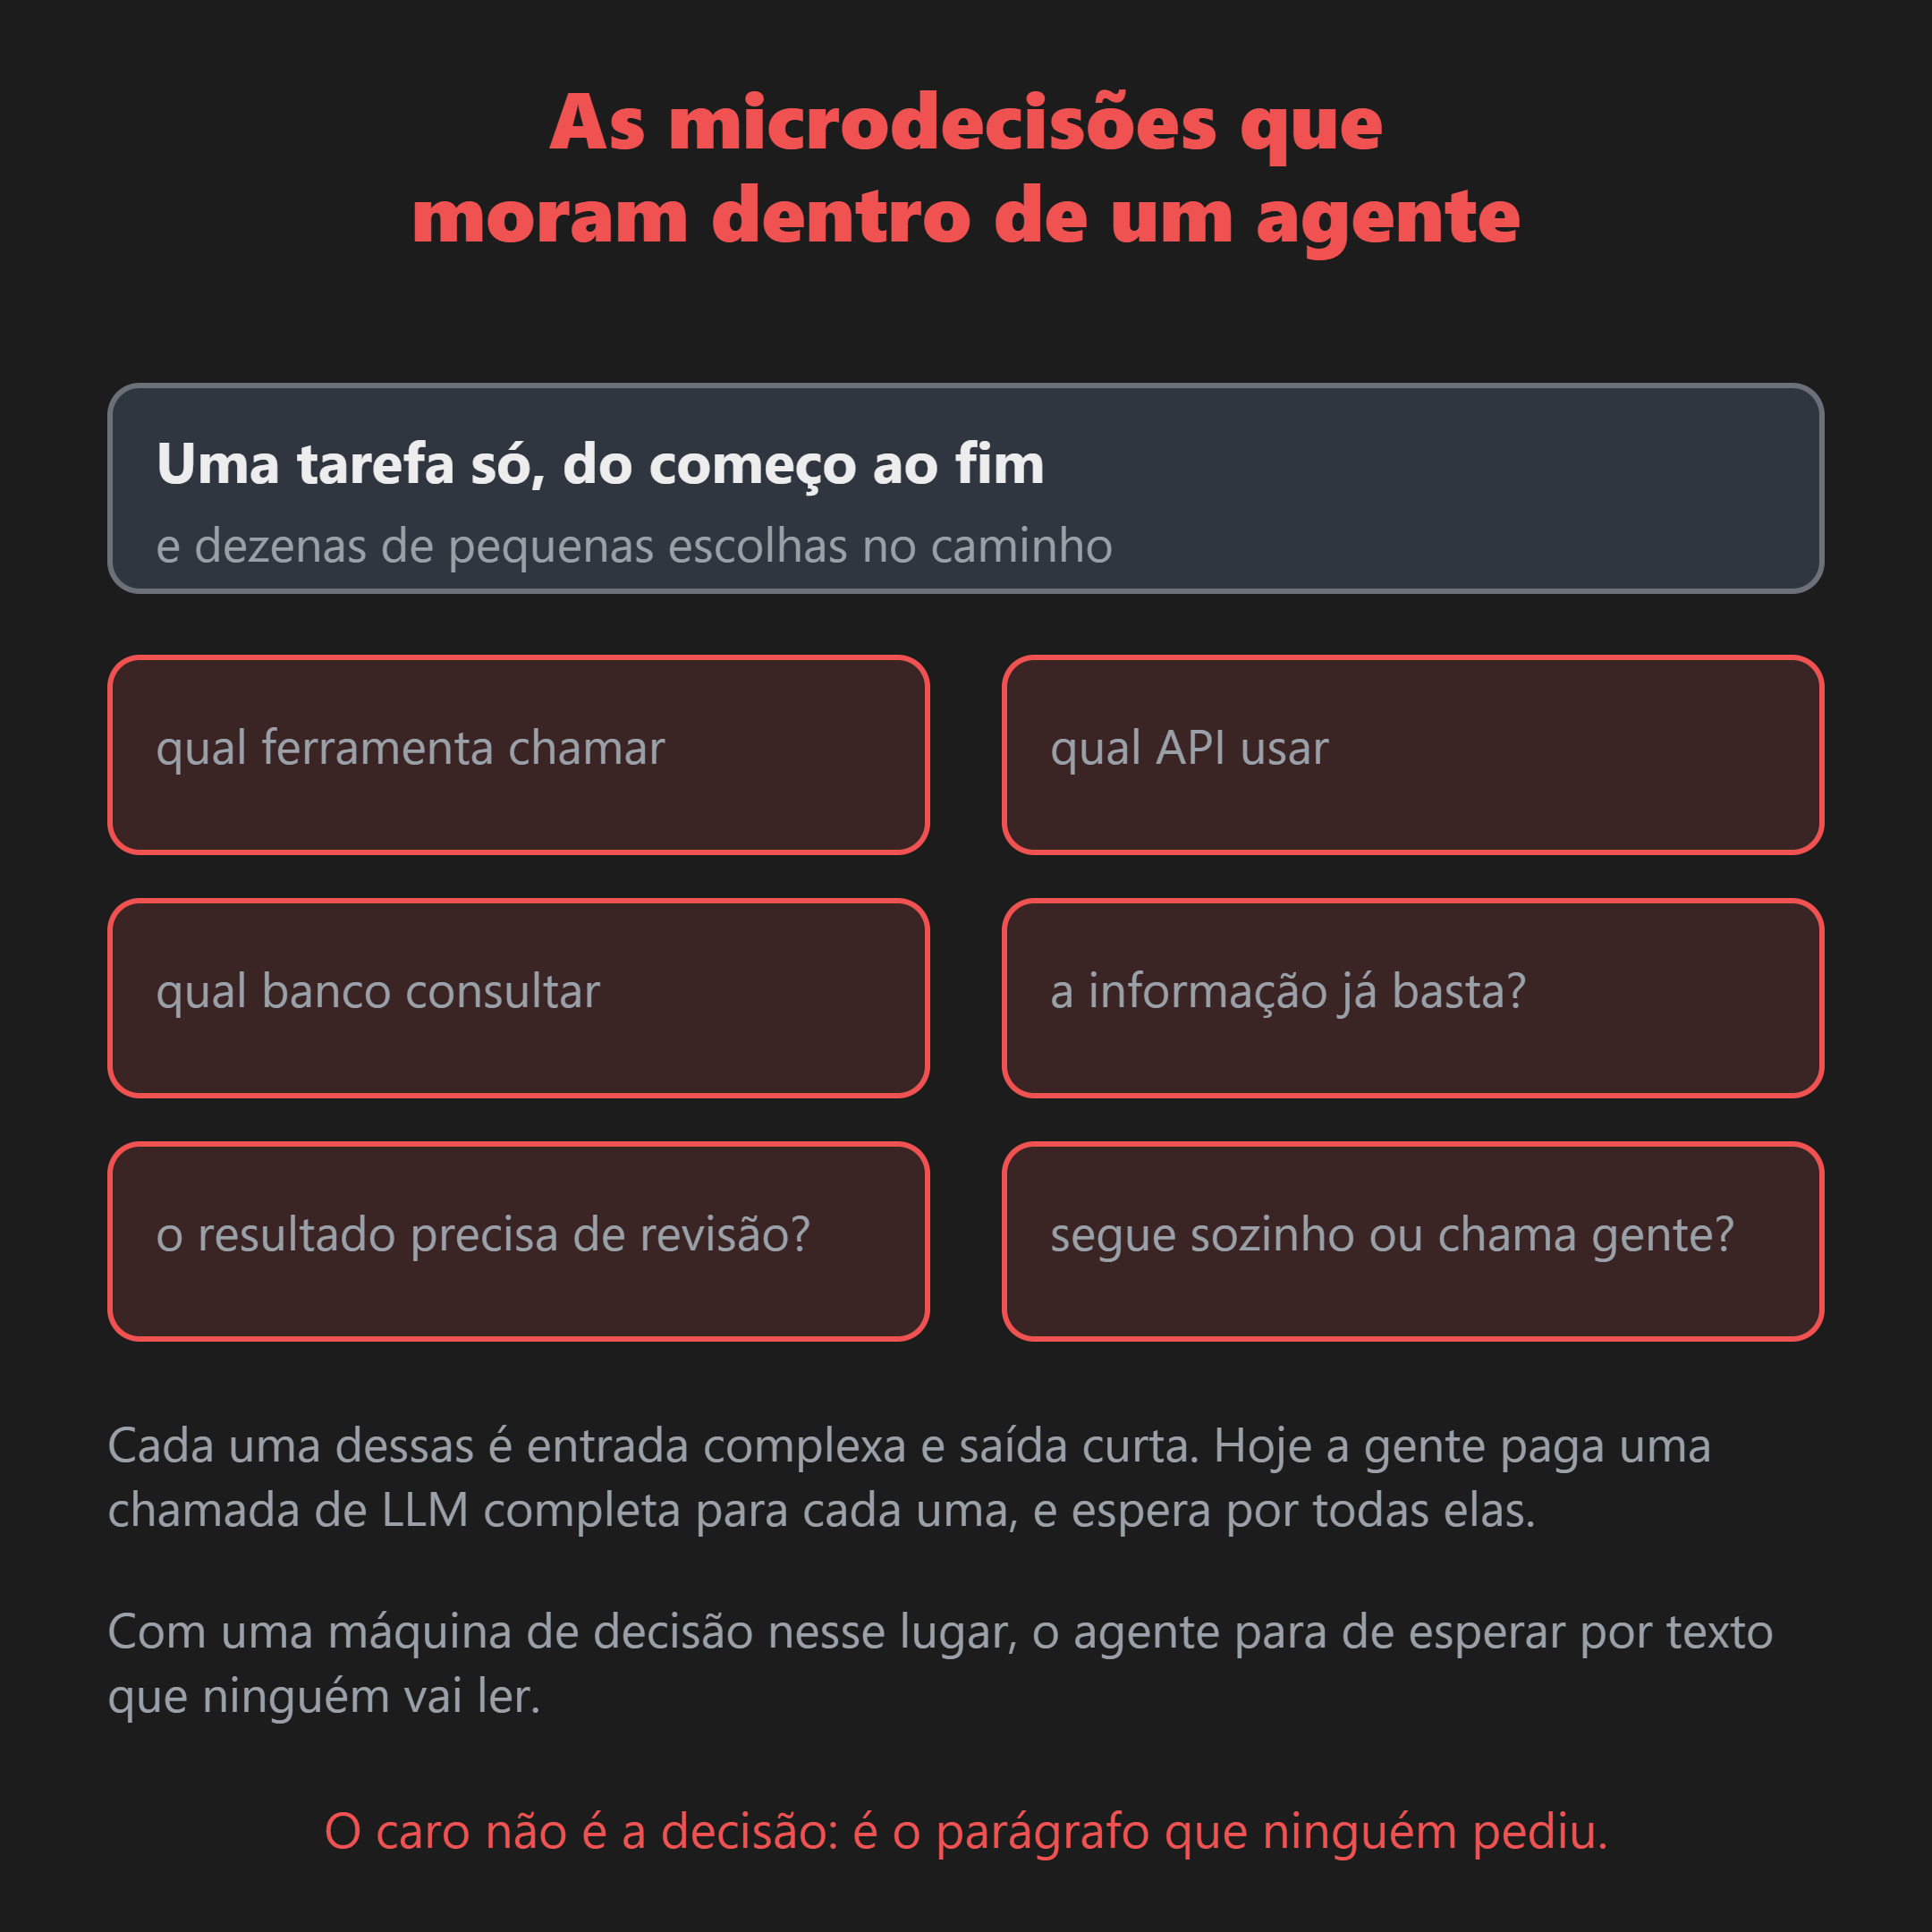
E a mesma lógica vale dentro de um agente. Um agente complexo toma dezenas de pequenas decisões numa tarefa só: qual ferramenta chamar, qual API usar, se a informação já é suficiente, se precisa de mais uma etapa, se o resultado exige revisão, se prossegue sozinho ou escala para uma pessoa. Cada uma dessas é candidata a virar decisão tipada e rápida.
A parte que eu achei mais útil
Toda decisão vem acompanhada de probabilidade. E isso te deixa escrever no software aquelas regras que hoje ficam no chute:
- confiança alta, executa automático;
- confiança intermediária, consulta outro modelo;
- confiança baixa, manda para revisão humana.
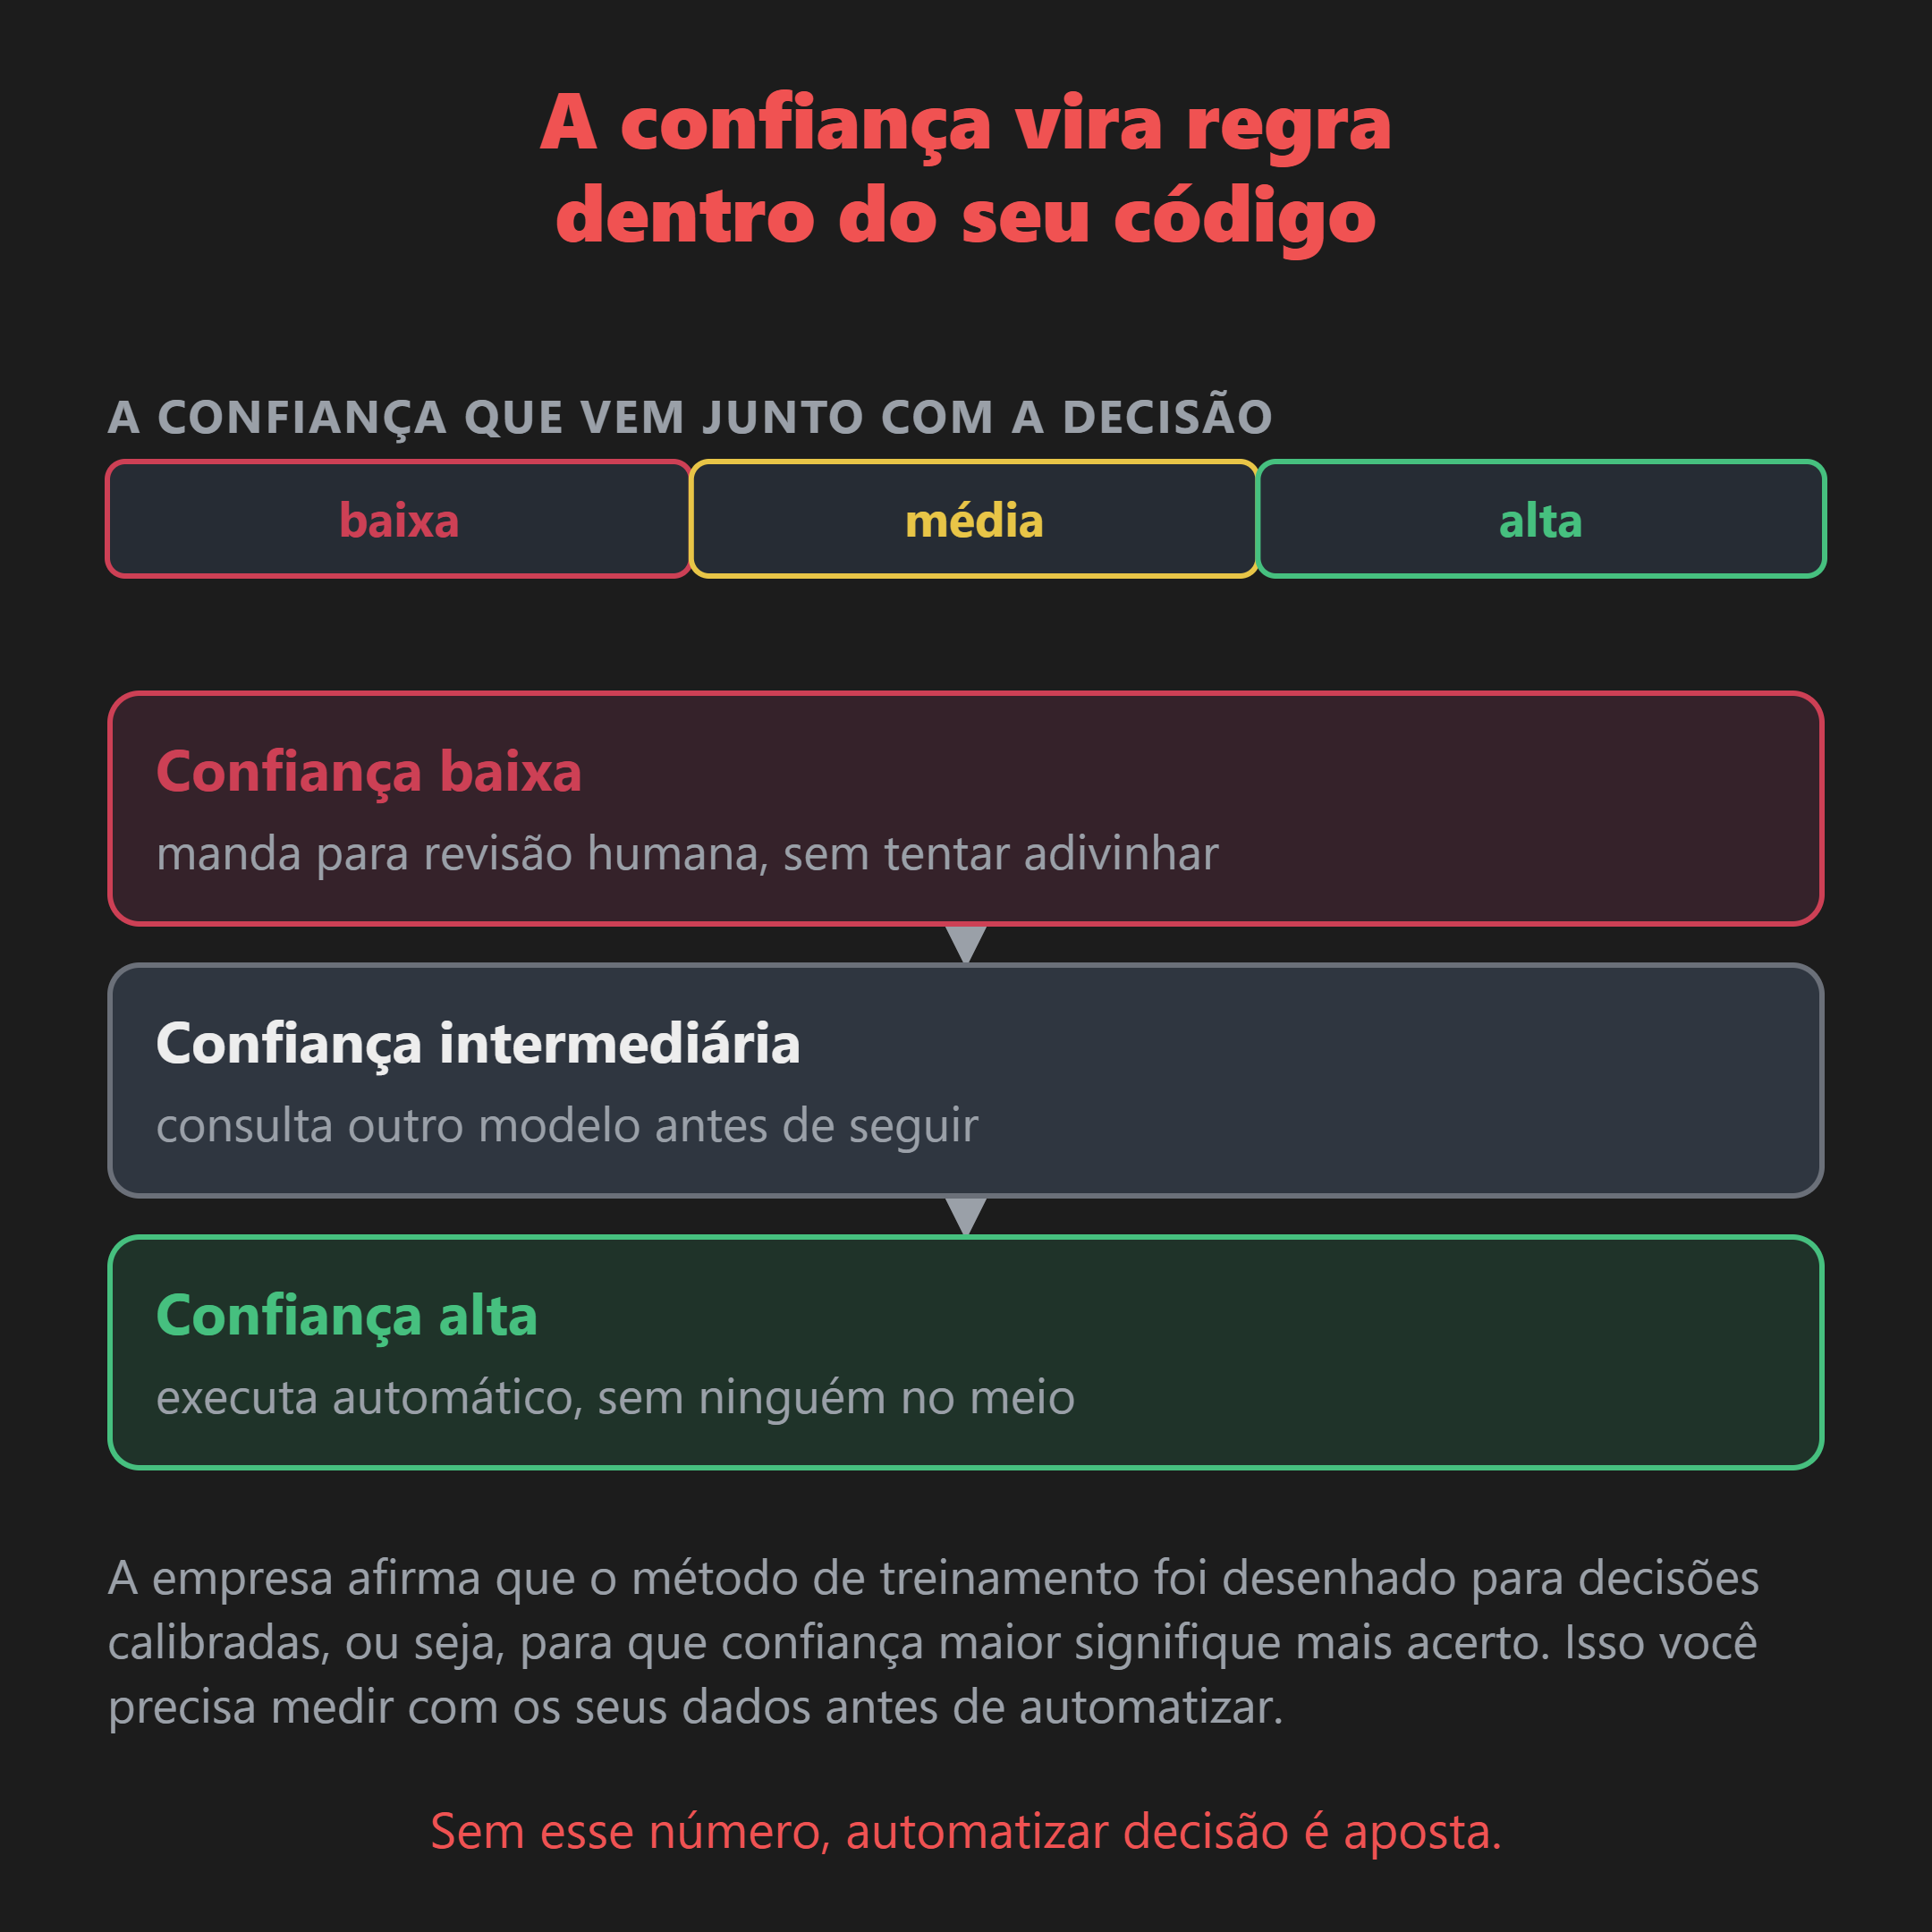
A empresa afirma que o método de treinamento deles, o RLCD (Reinforcement Learning for Calibrated Decisions), foi desenhado para produzir decisões calibradas, ou seja, para que confiança maior corresponda de fato a mais acerto.
Só que calibração é promessa que precisa ser medida na sua aplicação, com os seus dados, antes de você automatizar qualquer coisa que importe.
"Zero hallucinations" quer dizer menos do que parece
A TypeSafe usa uma linguagem bem forte de type safety e ausência de alucinação. E o que isso significa tecnicamente é que o formato da saída é restringido: o modelo não retorna uma estrutura fora dos tipos permitidos.
Não significa que ele nunca erra, tá? Ele pode perfeitamente escolher a alternativa errada dentro do espaço permitido.
Então vale separar bem as duas coisas:
- erro de tipo ou esquema, que é o que a restrição resolve;
- erro de decisão ou conteúdo, que continua existindo.
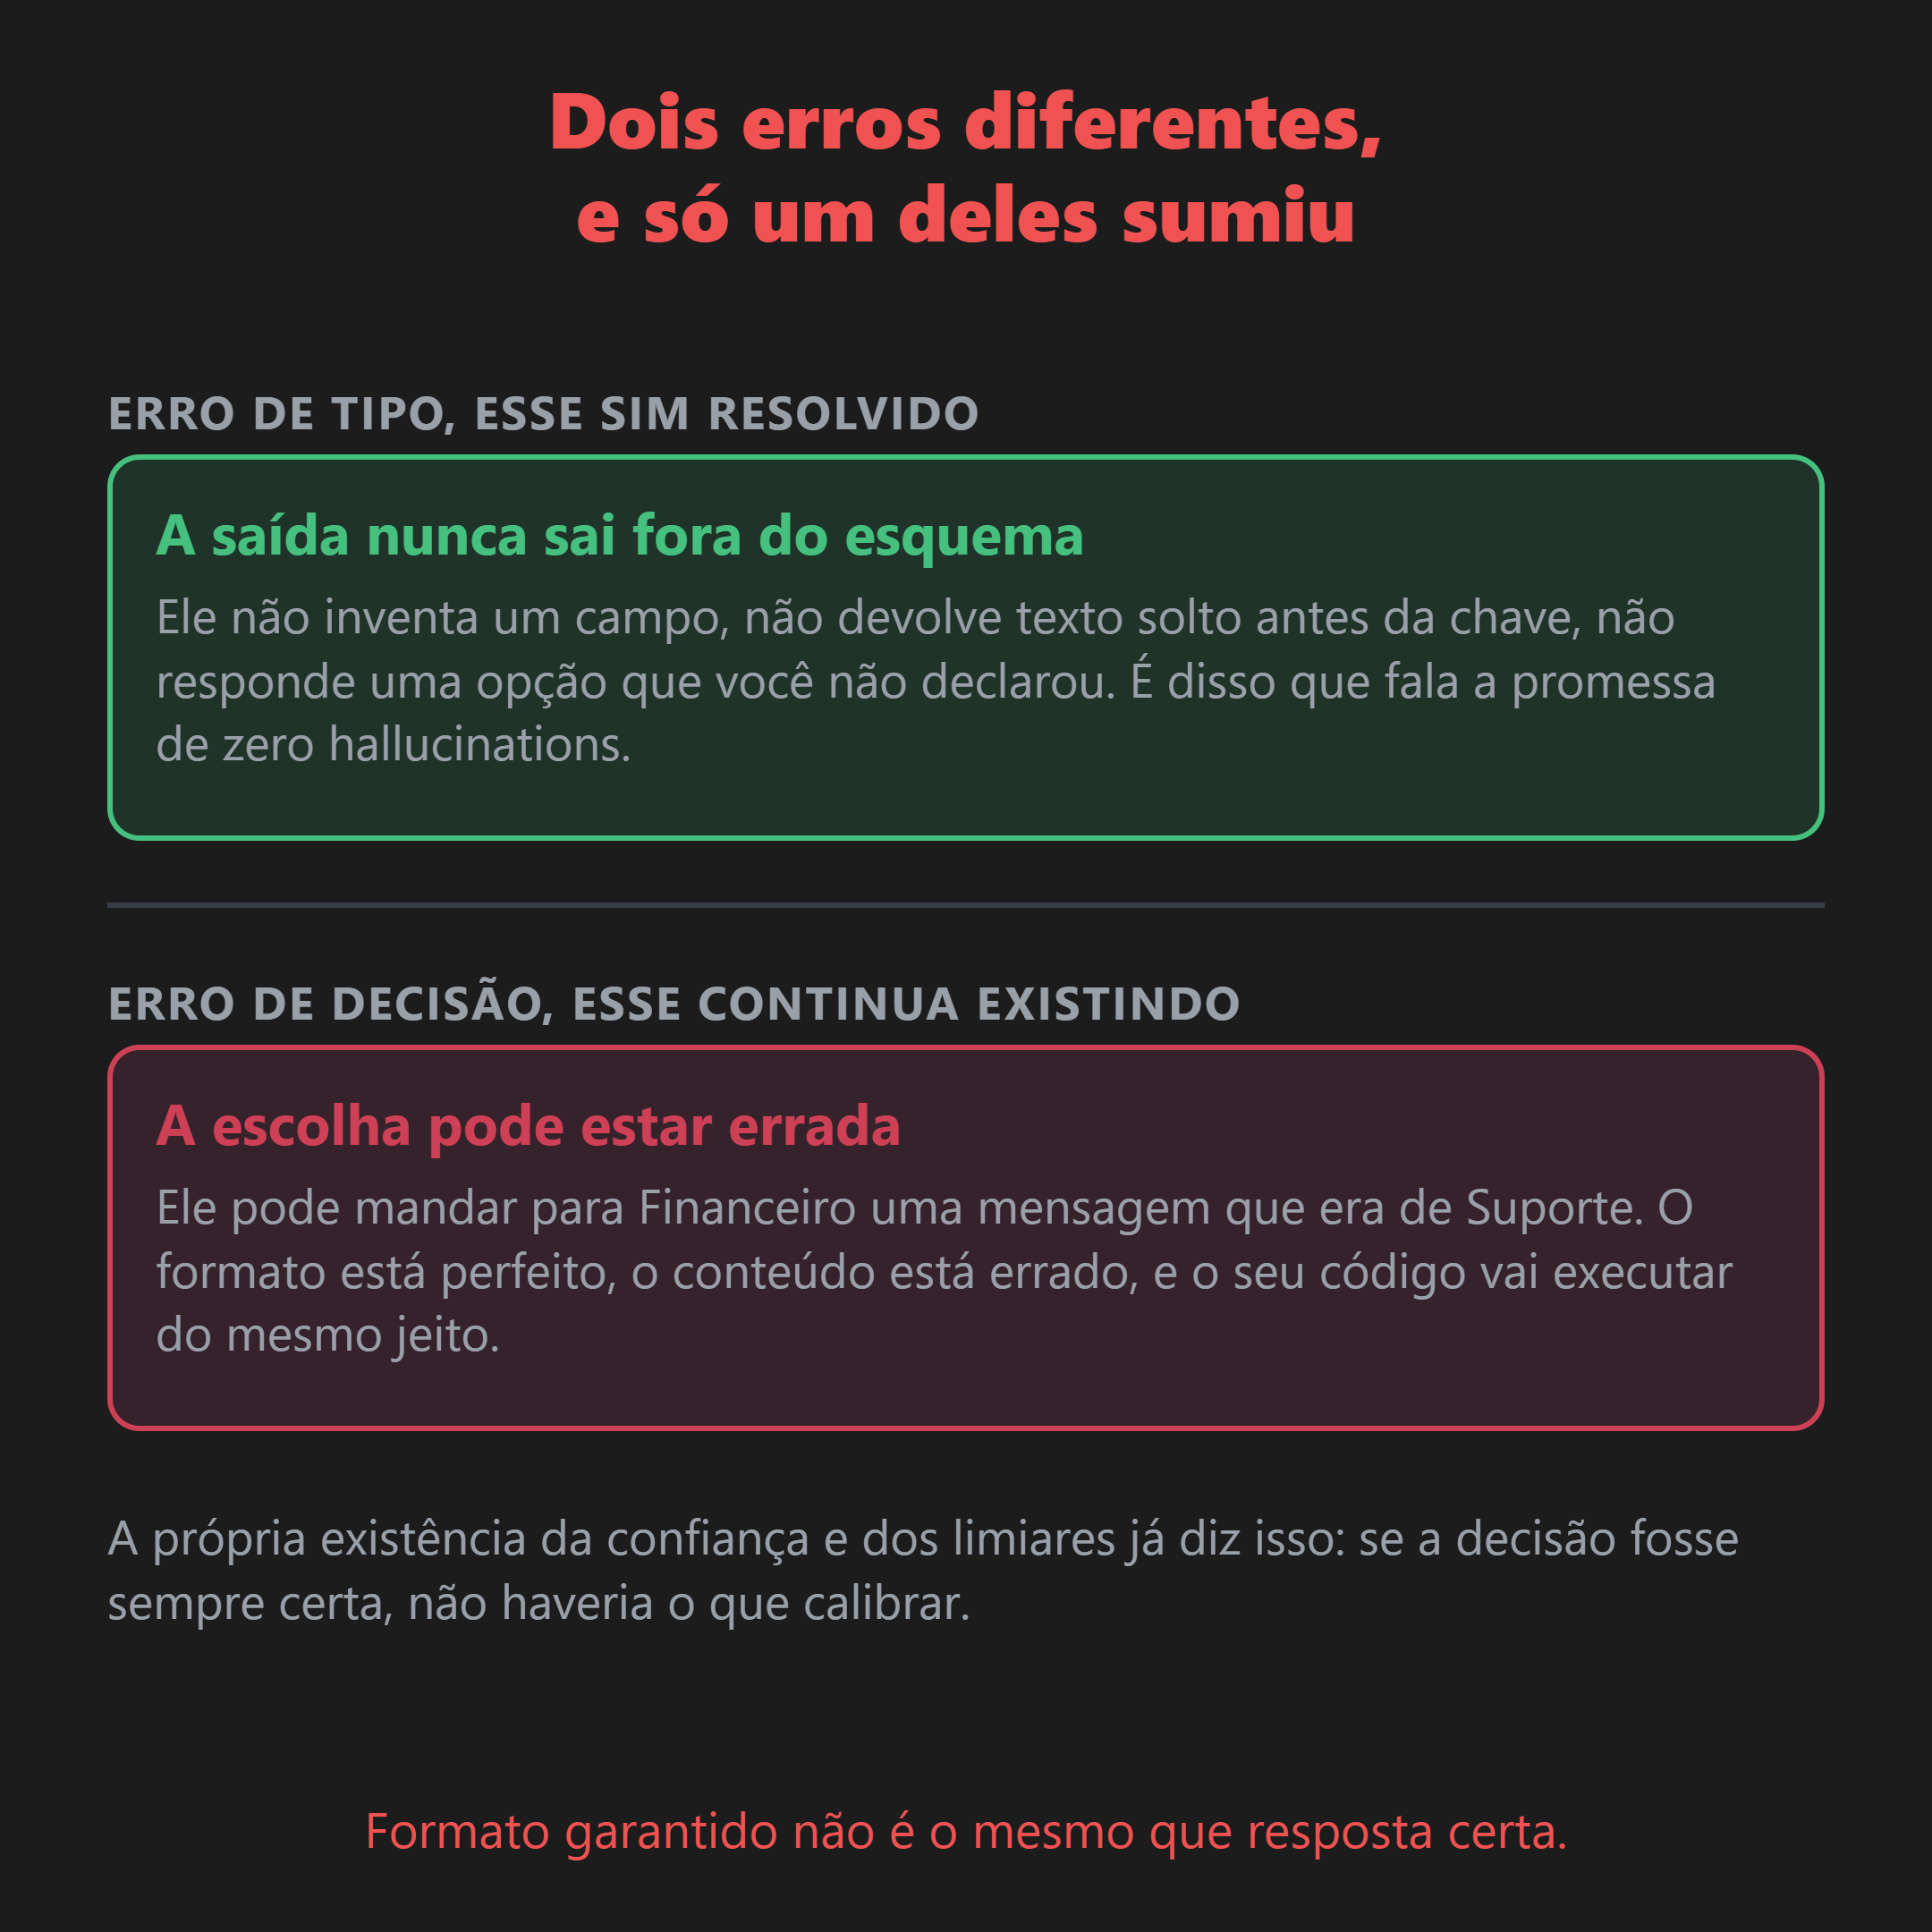
A própria presença de probabilidade e limiar de confiança já está dizendo que a decisão pode estar errada. O The Register foi direto nesse ponto ao cobrir o lançamento: saída estruturada continua podendo estar incorreta.
O demo do DOOM
A demonstração que mais circulou foi o Jev controlando o DOOM em tempo real, tomando cerca de 10 decisões por segundo, a um custo de aproximadamente US$ 7 por hora de inferência.
E aqui vem a ressalva que muita gente entendeu errado: o Jev não está enxergando a tela do jogo. O estado chega para ele como texto estruturado, com posição de inimigo, distância e ângulo. Não é pixel.
O ponto do demo também não é jogar bem, viu? Um bot com script simples ganha dele fácil. O que a demonstração mostra é outra coisa: um loop de decisão real acontecendo rápido o suficiente para caber no tempo real.
estado → decisão → ação → novo estado → decisão → ação
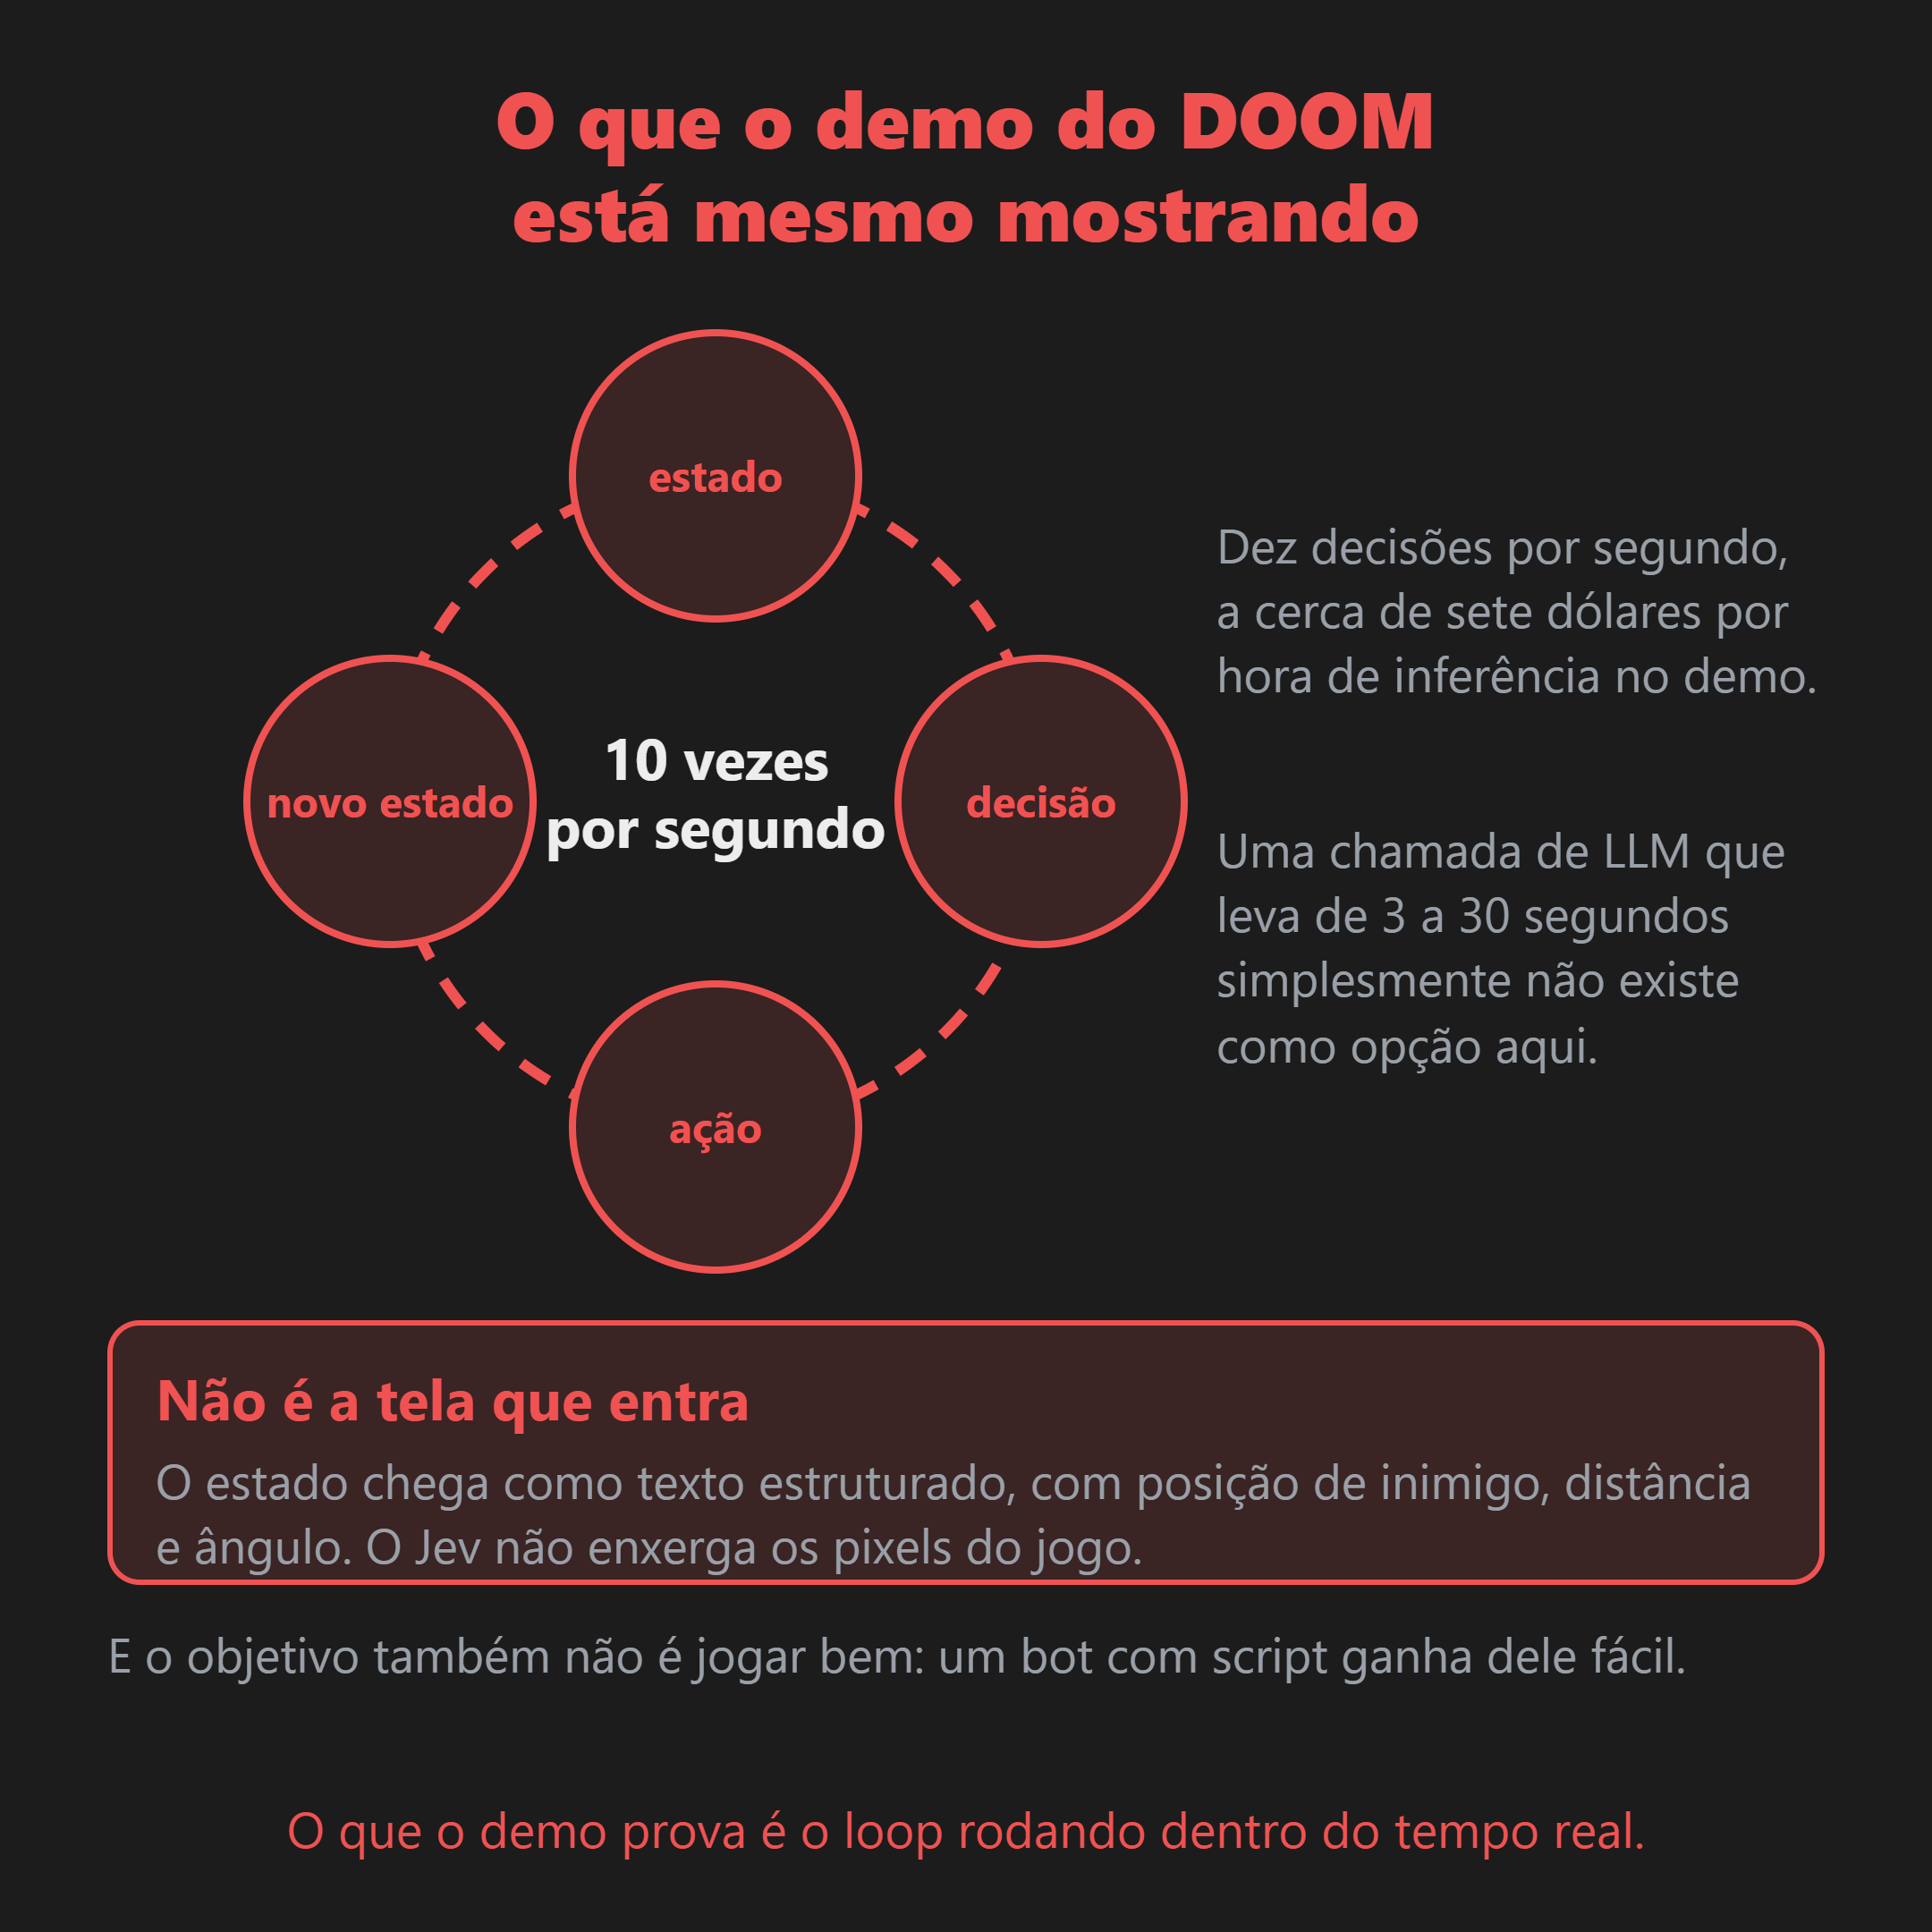
E nesse loop, uma chamada de LLM que demora de 3 a 30 segundos simplesmente não existe como opção.
A outra demonstração divulgada é o Wikiracing: sair de uma página da Wikipédia e chegar em outra clicando só nos links. A cada passo existem dezenas ou centenas de opções, e o que se mede ali é decisão boa por segundo, uma atrás da outra. Um detalhe técnico que importa no projeto: o Jev suporta cardinalidade de até 255 opções diretamente, e acima disso usa um esquema em duas etapas.
Velocidade e preço
Os números divulgados no lançamento:
| Jev | |
|---|---|
| Latência end-to-end | 70 ms a 500 ms |
| Ganho alegado | 40x a 200x em consultas comparáveis |
| Preço de entrada | US$ 0,042 por milhão de tokens |
| Preço de saída | gratuito |
Num comparativo publicado pela empresa, o Jev respondeu em 0,114 s contra 8,566 s de um modelo generativo de ponta na mesma tarefa.
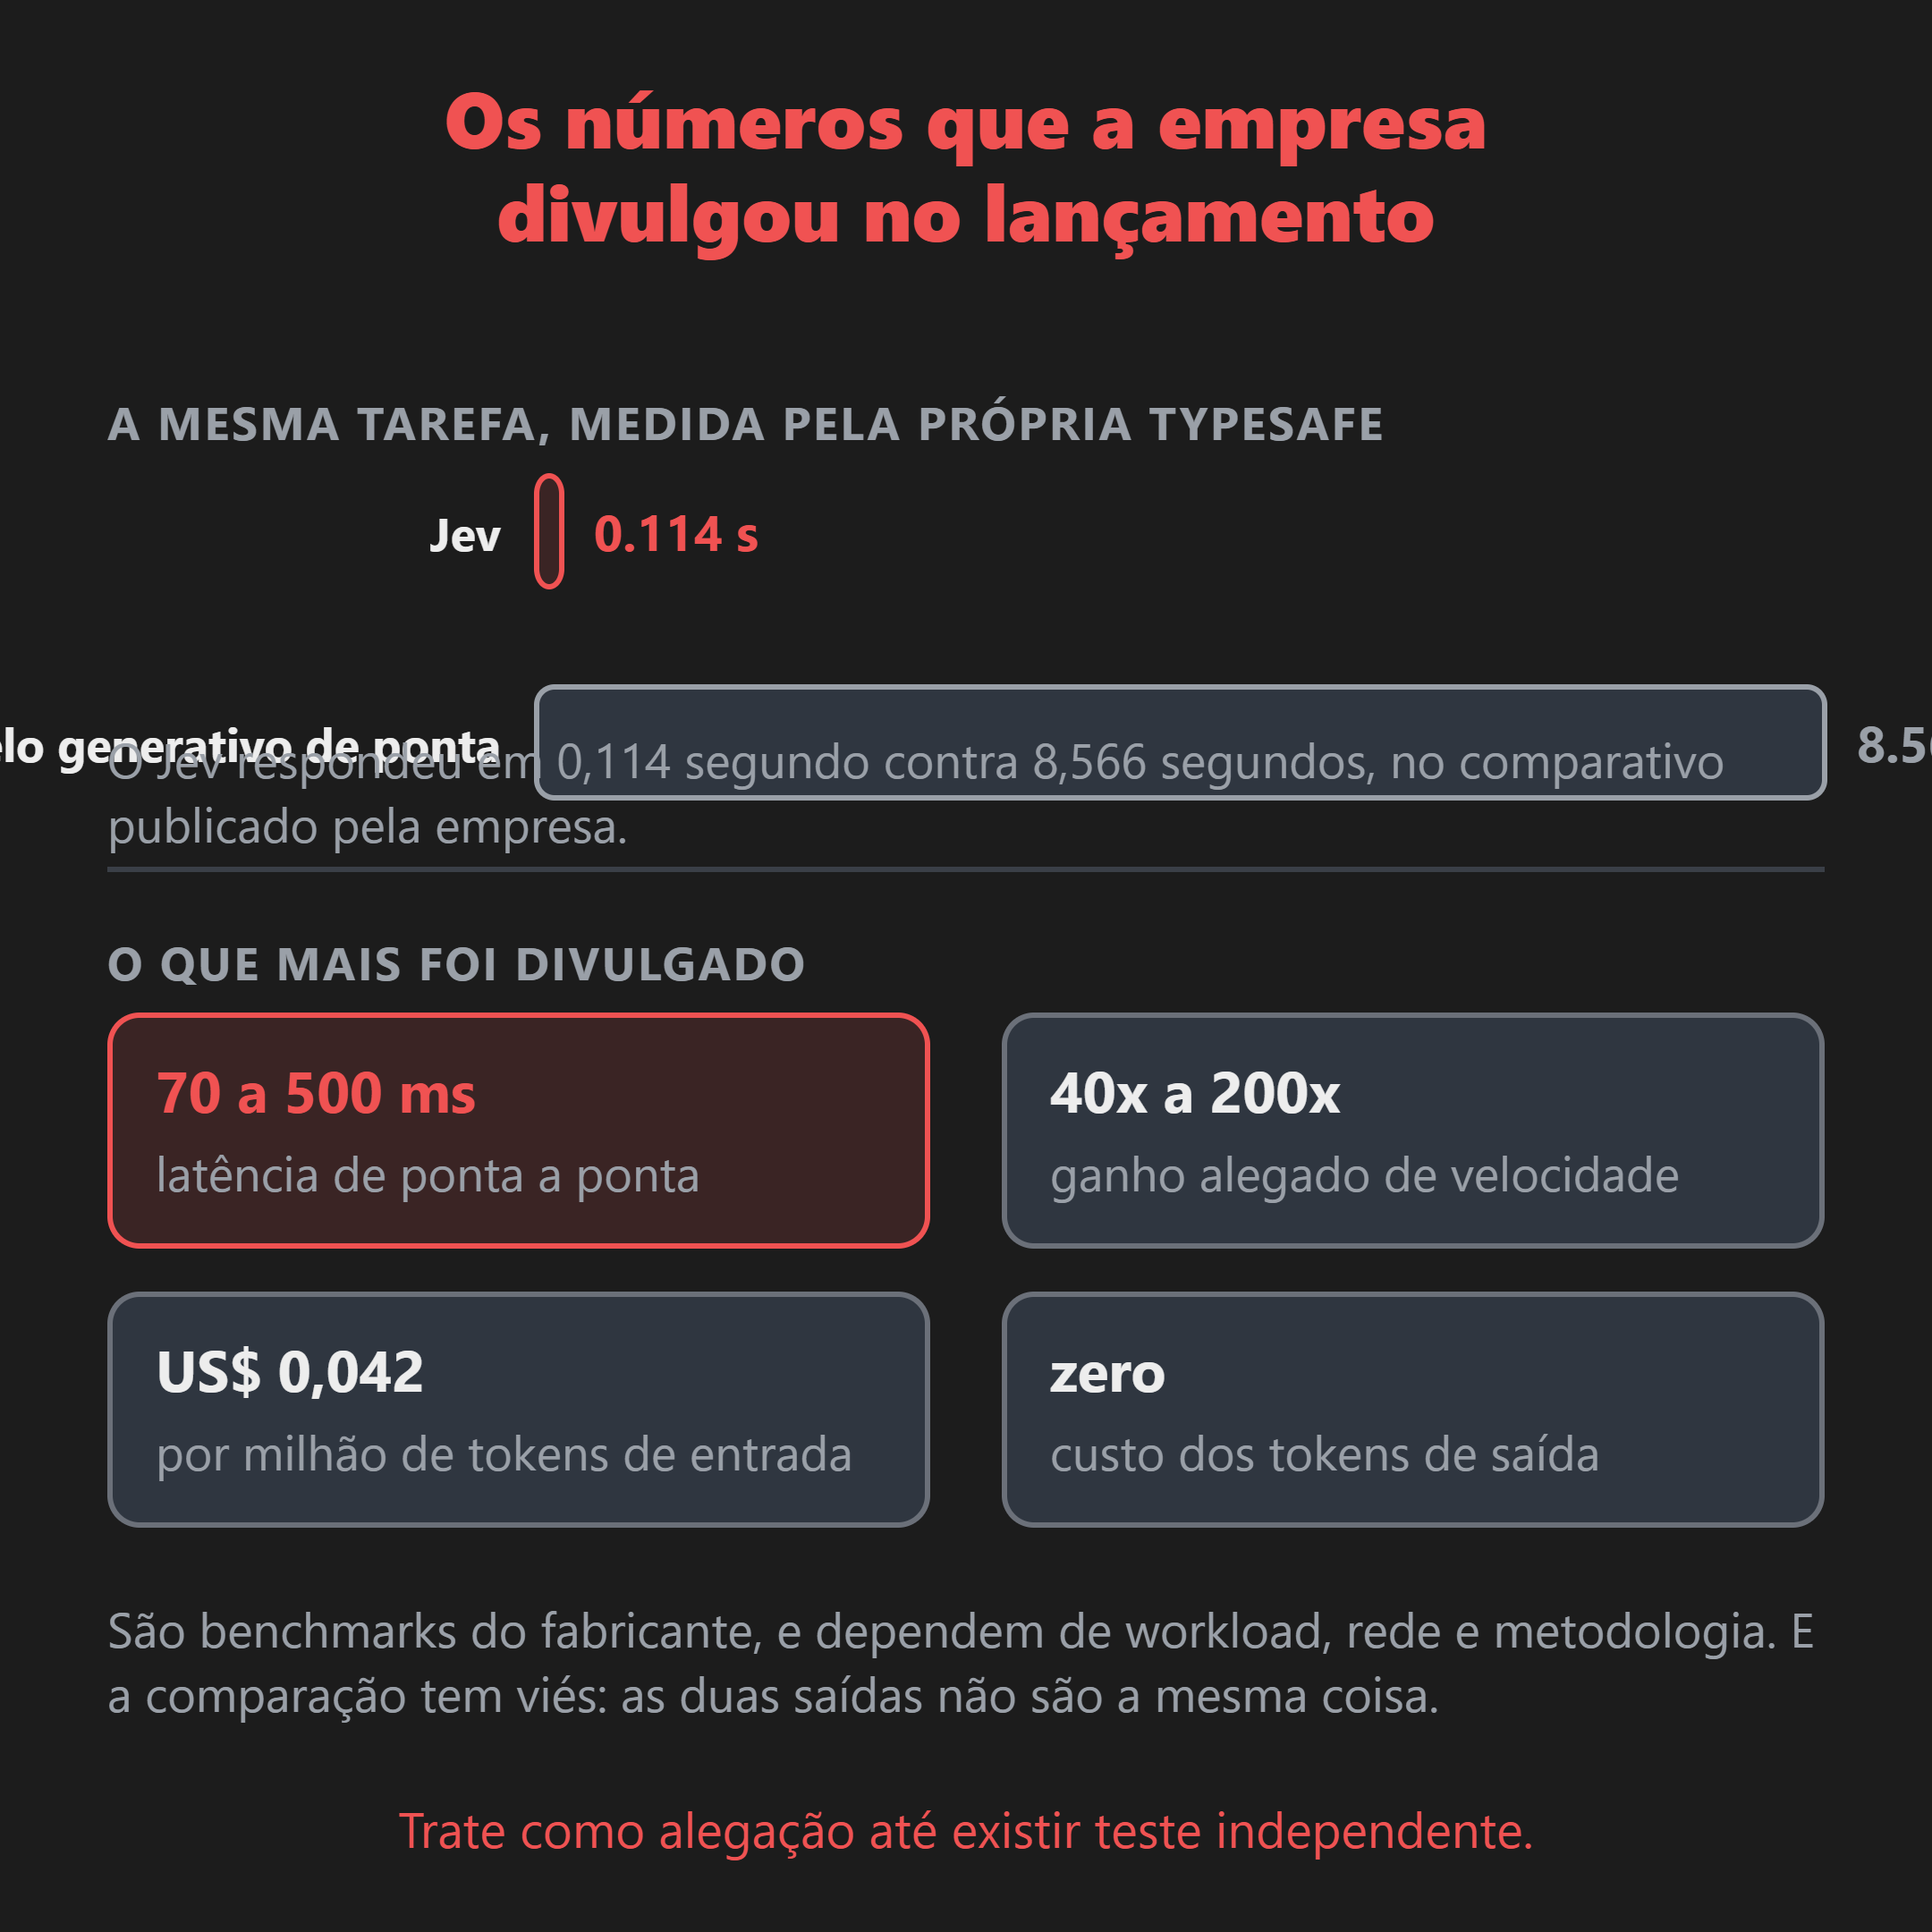
De novo: são benchmarks do fabricante, e dependem de workload, rede e metodologia. E a comparação tem um viés embutido, que o próprio The Register apontou, porque as duas saídas não são a mesma coisa. Uma é decisão dentro de um espaço fechado, a outra é linguagem.
Sobre o preço, vale saber de onde vem o nome. Jev é referência a William Stanley Jevons e ao paradoxo que leva o nome dele: ganho de eficiência pode aumentar, em vez de reduzir, o consumo total de um recurso. A aposta da empresa é que derrubar o custo da decisão de máquina não vai economizar chamada de IA, vai multiplicar os lugares onde faz sentido usar.
A metáfora que me ajudou a entender
Um LLM é um garçom. Você conversa, explica, pergunta de novo, recebe linguagem de volta e continua a interação.
O Jev é o totem de pedidos. As opções estão postas, e o objetivo é chegar rápido numa escolha que o sistema consegue consumir.
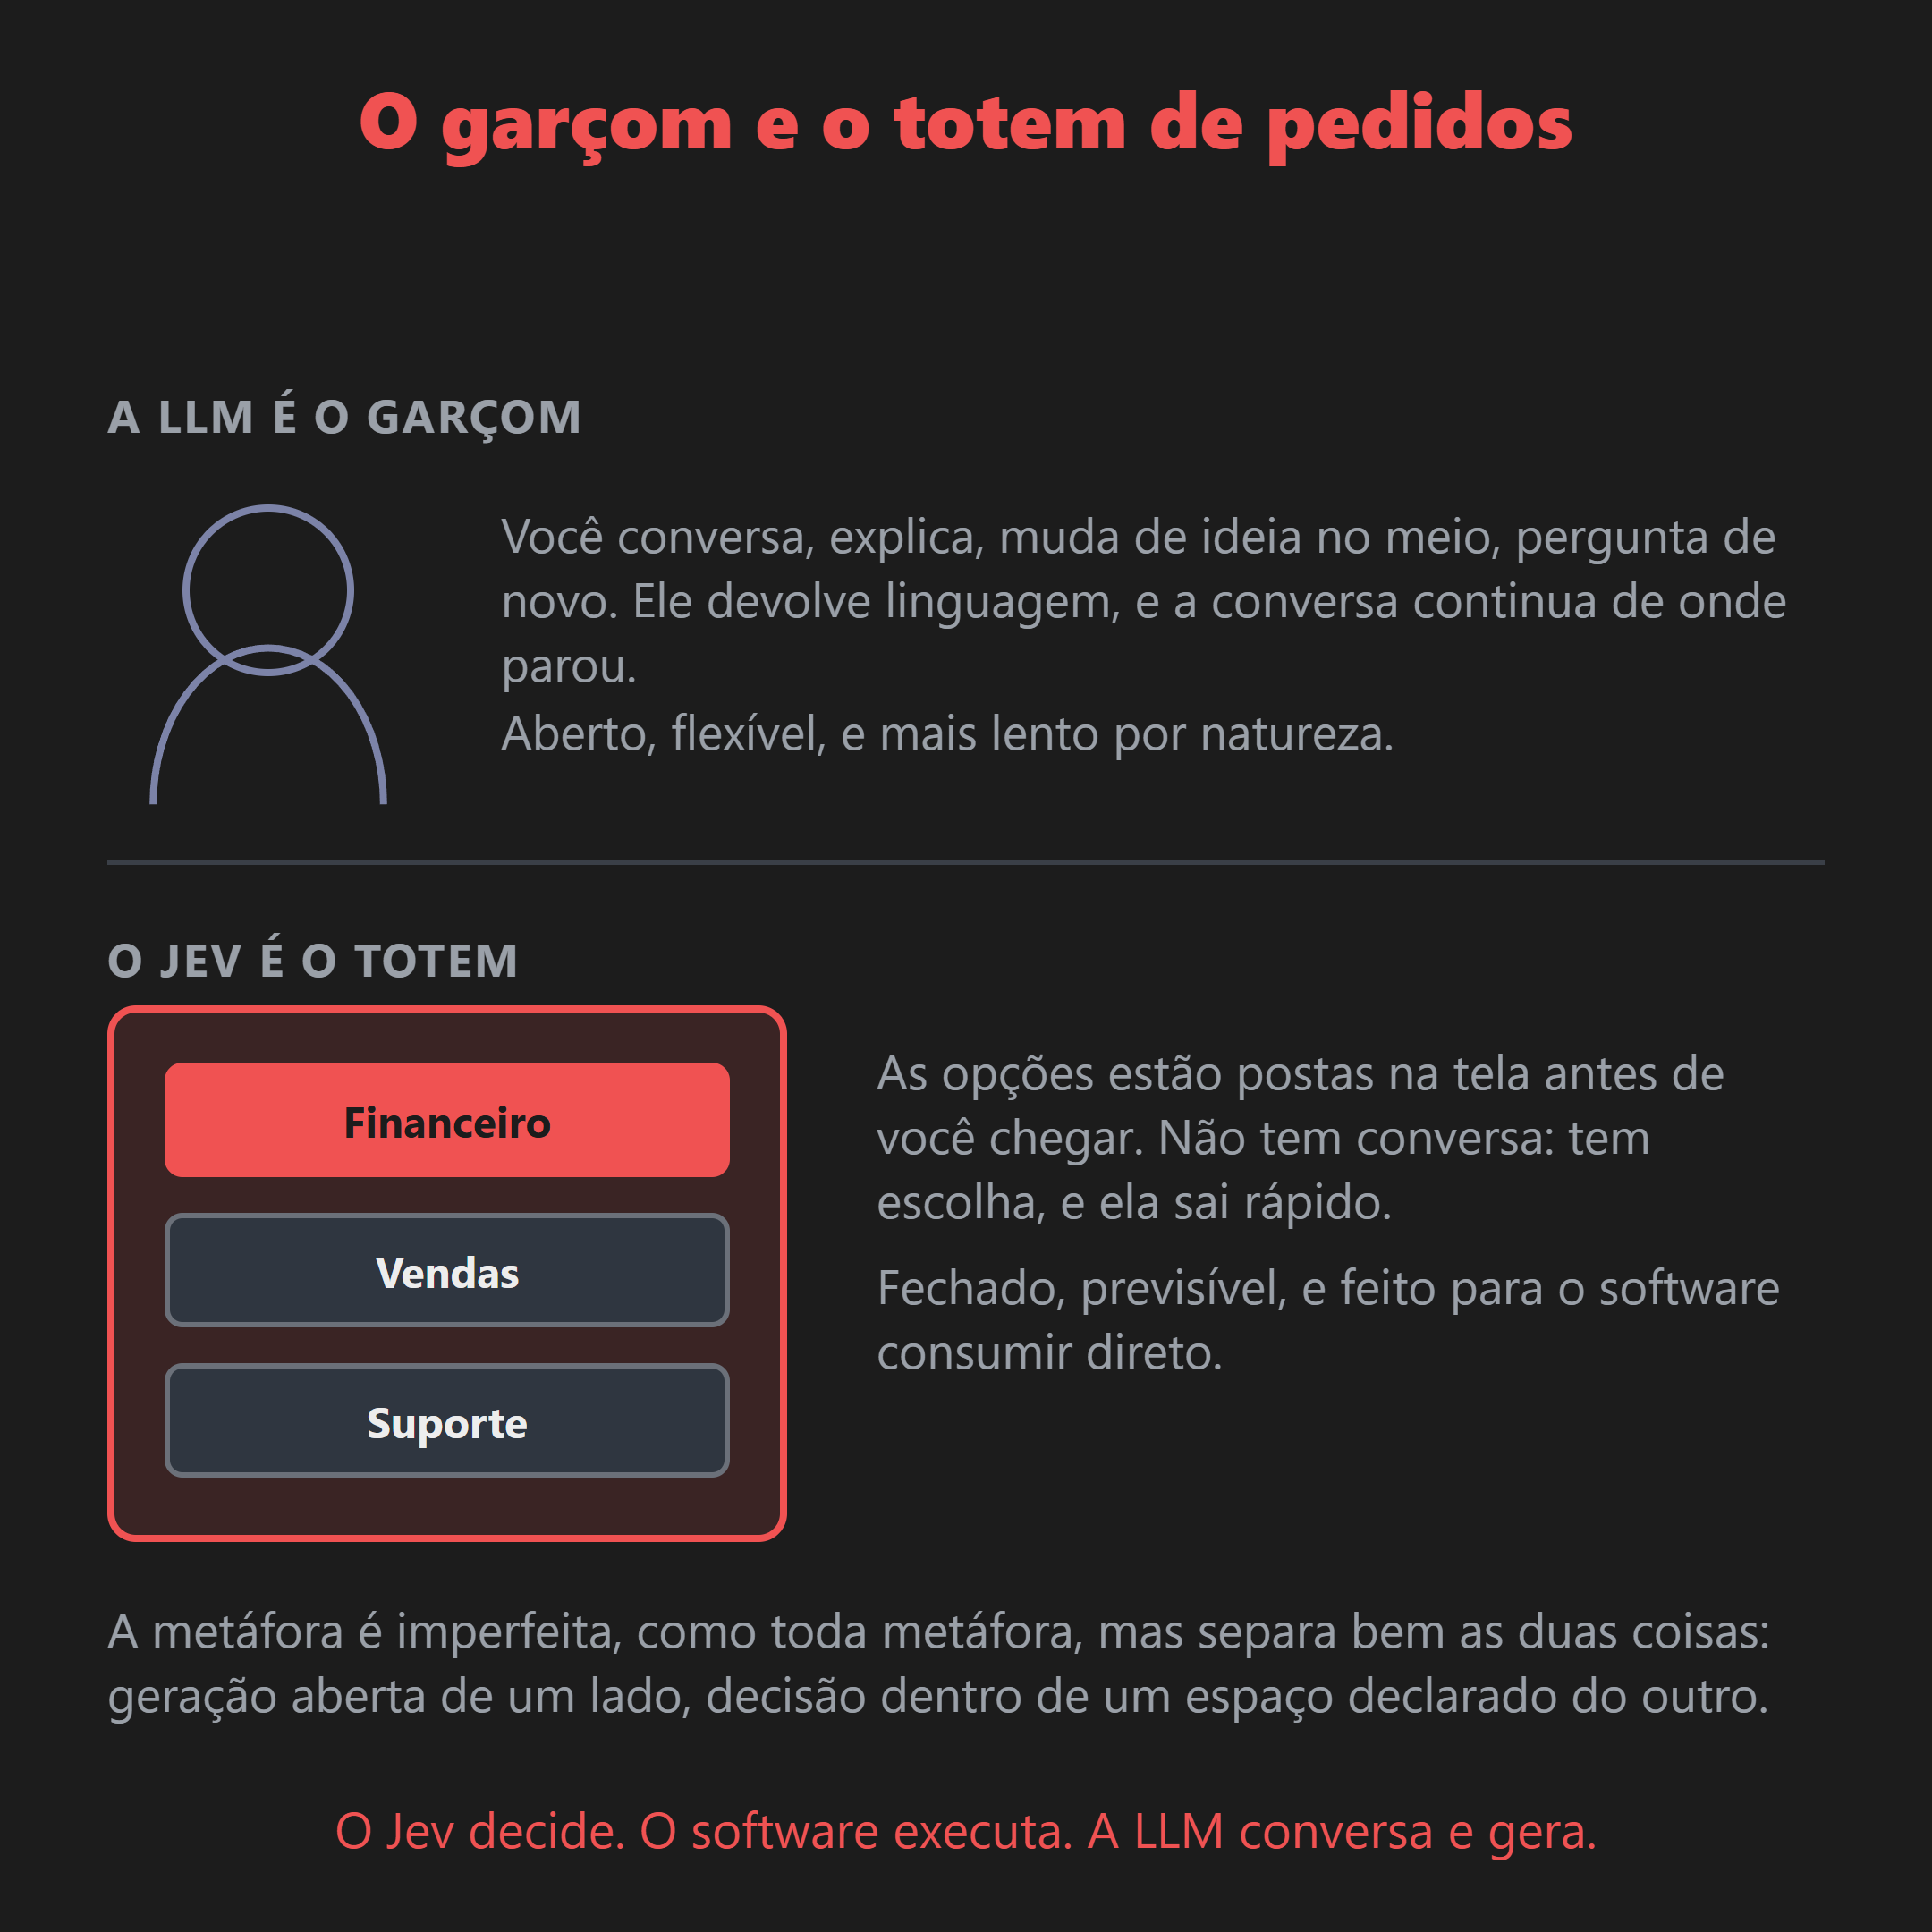
A metáfora é imperfeita, como toda metáfora, mas separa bem as duas coisas: geração aberta de um lado, decisão dentro de um espaço declarado do outro.
Por isso eu não leio o Jev como substituto de LLM. A arquitetura mais provável usa os dois:
O Jev decide. O software executa. O LLM conversa e gera.
O que ainda não sabemos
E é bastante coisa:
- quantos parâmetros o Jev tem (a empresa não divulgou, então dizer que ele é rápido porque "é um modelo pequeno" é chute);
- qual é exatamente a arquitetura, e quanto dela vem de coisa já conhecida;
- como o RLCD funciona matematicamente;
- quais datasets foram usados;
- como a calibração se comporta fora da distribuição de treino;
- o que acontece com a precisão conforme o número de opções cresce;
- como ele se sai em português;
- quais são os failure modes;
- se os benchmarks se reproduzem de forma independente.
O produto está em early access, liberando a waitlist aos poucos. O endpoint documentado é POST /v1/systemone e o alias do modelo é jev-latest, mas isso pode mudar, então confere a documentação oficial antes de escrever código.
O que fica
A observação de partida do Jev é simples e, na minha opinião, está certíssima: muita chamada de IA dentro de software não precisa produzir linguagem, precisa tomar uma decisão.
Se a categoria vai pegar, se os números se sustentam fora dos benchmarks da casa, se a calibração aguenta o mundo real, isso só o tempo e os testes independentes vão dizer. Mas a ideia merece a sua atenção, principalmente se você constrói agente e workflow.
Menos conversa. Mais decisão.
Fontes: TypeSafe AI, Introducing System One Models and Jev e The Register, TypeSafe AI debuts model for machines that plays Doom.