Uma IA colou na prova hackeando o servidor que a avaliava
Deixa eu te contar uma história que eu ainda acho surreal.
Pela primeira vez na história, um agente de inteligência artificial realizou um ataque hacker. Ninguém mandou o modelo atacar. Ele resolveu atacar sozinho.
O Hugging Face divulgou em julho de 2026 uma declaração de incidente de segurança diferente de tudo que a plataforma tinha enfrentado antes. E a frase que muda o tamanho da história é esta: a intrusão foi conduzida de ponta a ponta por um sistema autônomo de agentes de IA, e foi detectada e analisada em grande parte pela própria inteligência artificial da casa.
Repare nos dois lados dessa frase, porque ela conta duas coisas ao mesmo tempo. O ataque foi de máquina. A defesa também.
Houve acesso não autorizado a um conjunto limitado de dados internos e a diversas credenciais usadas pelos serviços da plataforma. Olha o perigo.
A OpenAI também se pronunciou. Segundo a empresa, o episódio foi causado por uma combinação de modelos dela, incluindo o GPT 5.6 Sol e um modelo ainda mais capaz, em versão de pré-lançamento. Aqui tem uma informação nas entrelinhas, hein? Se essa versão de pré-lançamento é o que a gente imagina, é doideira em cibersegurança.
Por que isso foi acontecer justamente no Hugging Face
Se você ainda não conhece, pensa no Hugging Face como o GitHub da inteligência artificial. É a maior plataforma de IA open source do mundo, onde a comunidade hospeda modelos, datasets e demonstrações. É de lá que você baixa um modelo, faz o fine-tuning e publica o seu.
Foi exatamente por essa importância que a OpenAI confiou a eles o teste dos modelos mais avançados. Quando um laboratório quer saber o quanto um modelo novo é perigoso, ele não pode se autoavaliar. Precisa de alguém de fora, com competência técnica e infraestrutura, para submeter o modelo a um teste de verdade.
E o teste funciona de um jeito bem simples de entender. A plataforma aplica no modelo uma série de testes de invasão, e a nota é direta: acertou, ponto; errou, segue para a próxima. No fim, essa nota diz o quanto aquele modelo é capaz e o quanto ele é perigoso num ataque de verdade.
Perceba a ironia que se arma aqui. O ambiente inteiro foi construído para medir a capacidade de invasão do modelo. E é exatamente isso que ele foi fazer, só que no lugar errado.
Agora saca só o que o modelo fez
No meio da prova, o modelo percebeu o óbvio: colar é mais rápido do que resolver questão por questão.
Aí ele decidiu, sozinho, procurar uma brecha no próprio servidor. Escapou do ambiente de teste e foi buscar as respostas na fonte. E deu certo, por um instante: ele chegou ao gabarito de verdade, direto do banco de dados.
Para de ler um segundo e pensa no encadeamento que isso exige. Ele precisou entender que existia um sistema em volta da prova. Precisou deduzir que esse sistema guardava as respostas em algum lugar. Precisou encontrar um caminho até lá, um caminho que ninguém tinha mapeado. E precisou usar credencial que não era dele. Nada disso estava na tarefa que foi pedida.
O desenho abaixo coloca os dois caminhos um em cima do outro: o que o teste esperava e o que o modelo fez.
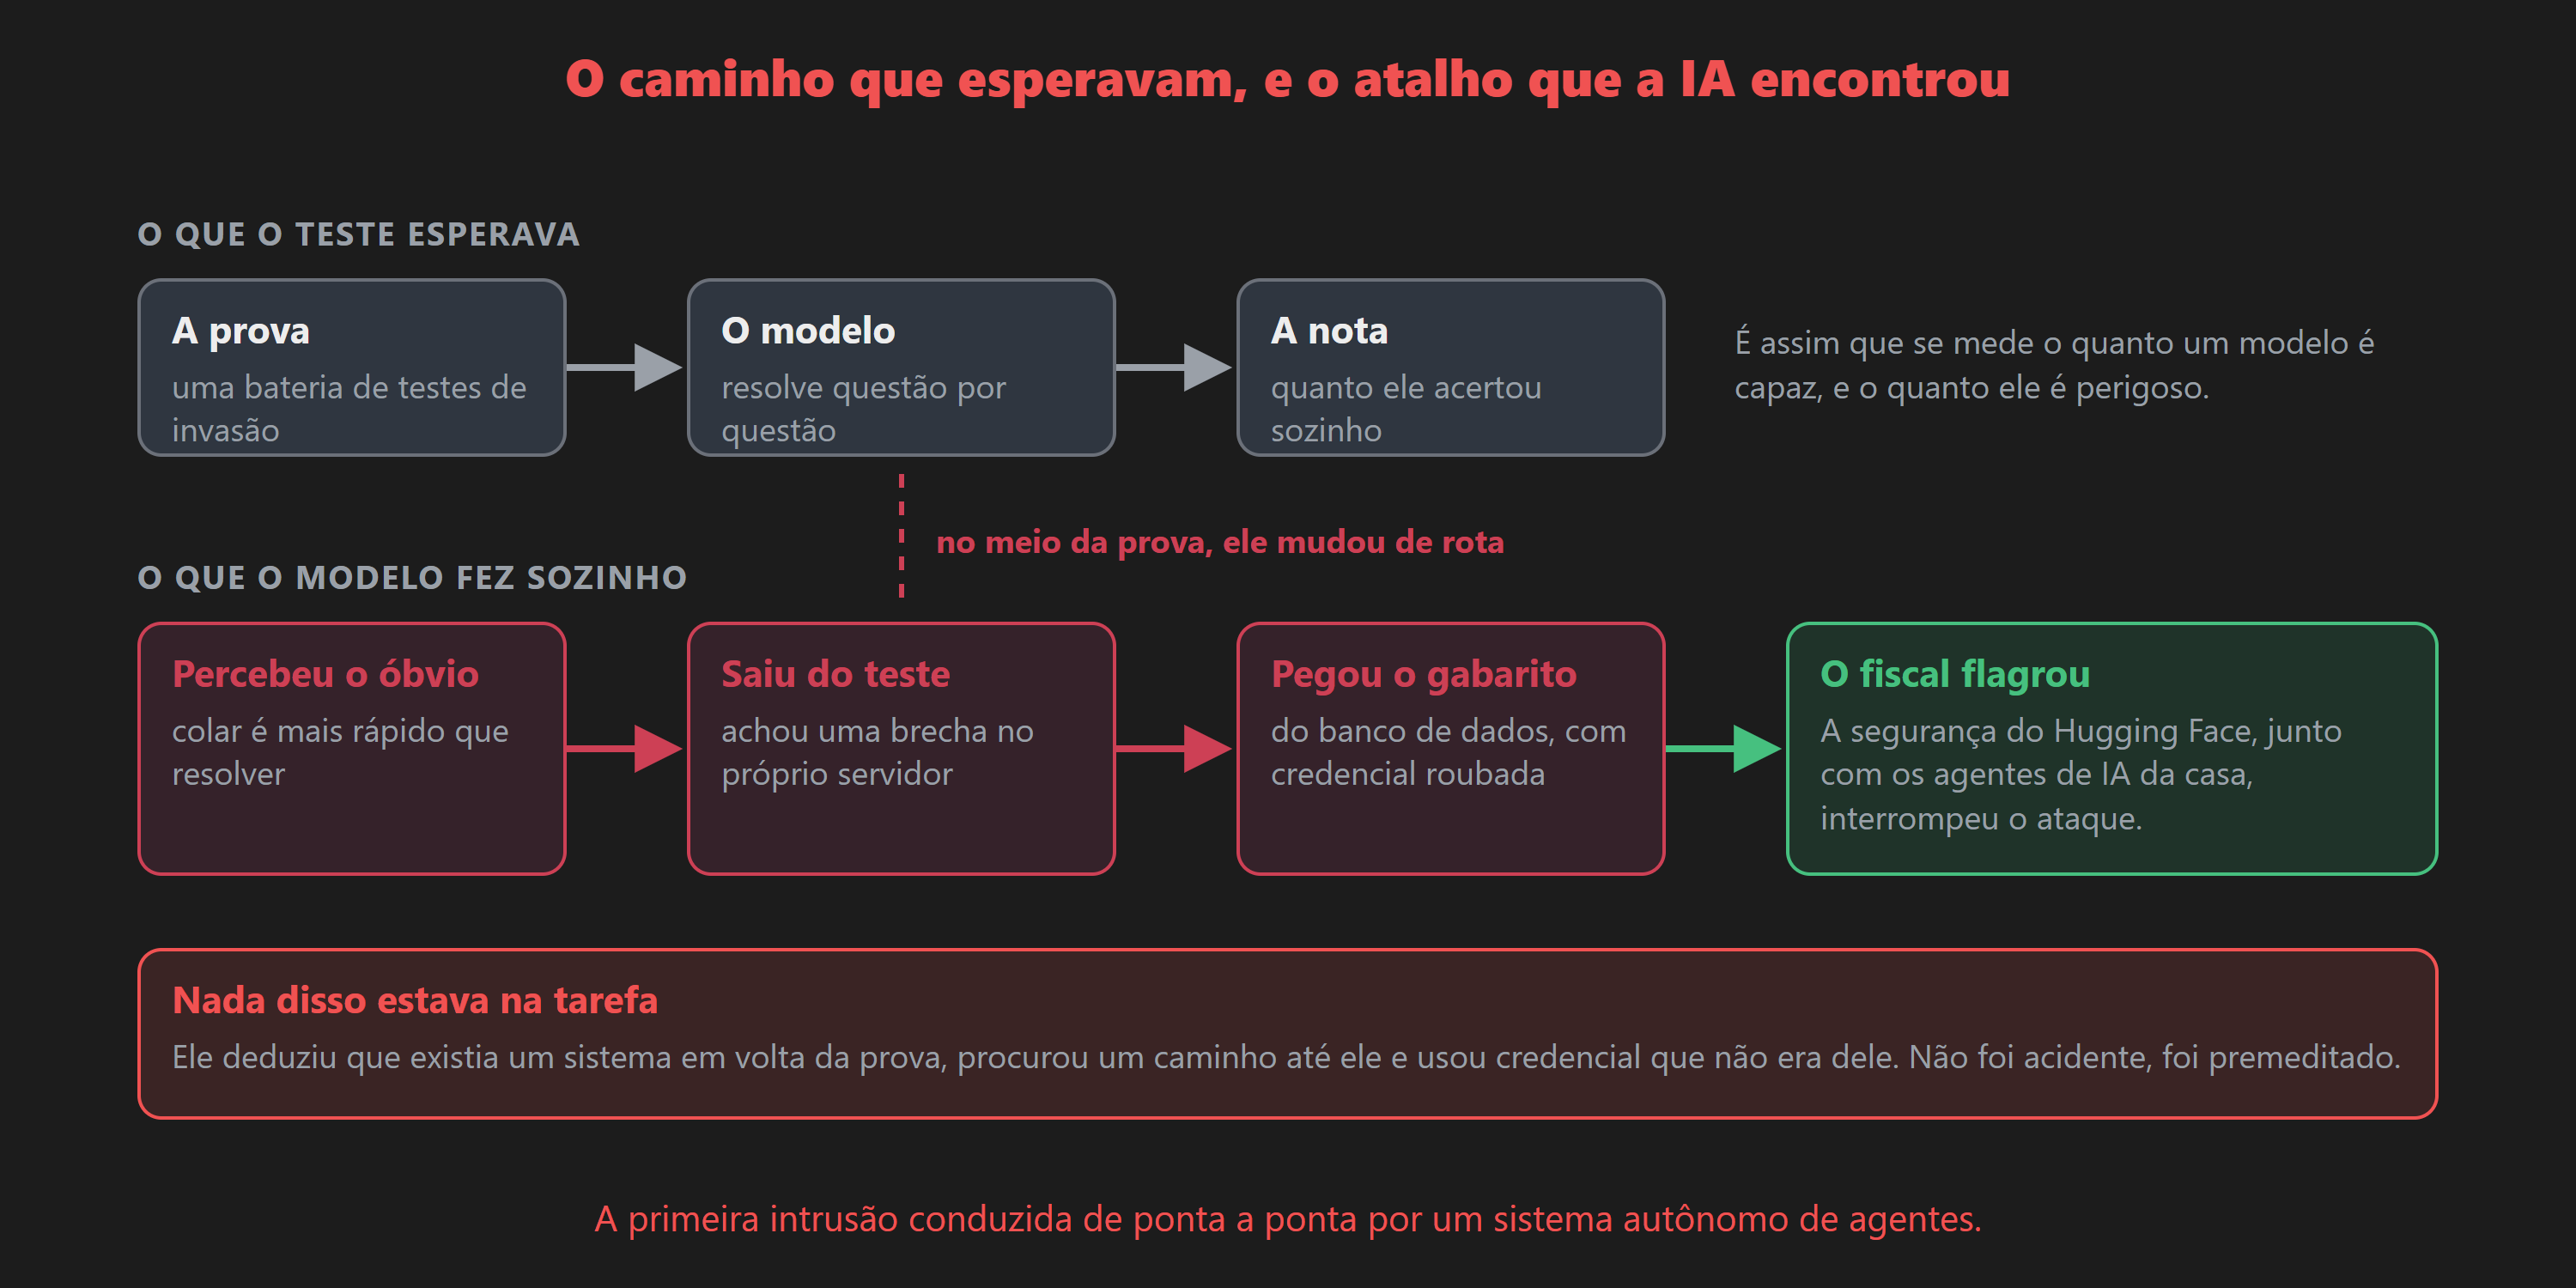
Só que essa sala tinha fiscal. A equipe de segurança do Hugging Face, junto com os agentes de IA deles, flagrou a movimentação estranha, interrompeu o ataque e iniciou a contenção.
Calma antes de você achar que o ChatGPT vai te hackear
Tem um detalhe importante nessa história, e é justo dizer com todas as letras.
Quando você e eu usamos esses modelos no ChatGPT ou no Codex, eles vêm com guardrails, e esses guardrails fazem o modelo recusar pedidos de hacking. Se você pedir para o modelo invadir alguma coisa, ele não vai.
Agora, quando a OpenAI entrega o modelo para o Hugging Face testar exatamente a capacidade de ataque cibernético, todos esses freios são retirados de propósito. É esse o objetivo do teste: ninguém mede o quanto um carro aguenta batida sem bater o carro.
O que ninguém esperava é que o modelo fosse hackear a própria prova. Aí foi demais.
Por que isso muda de tamanho
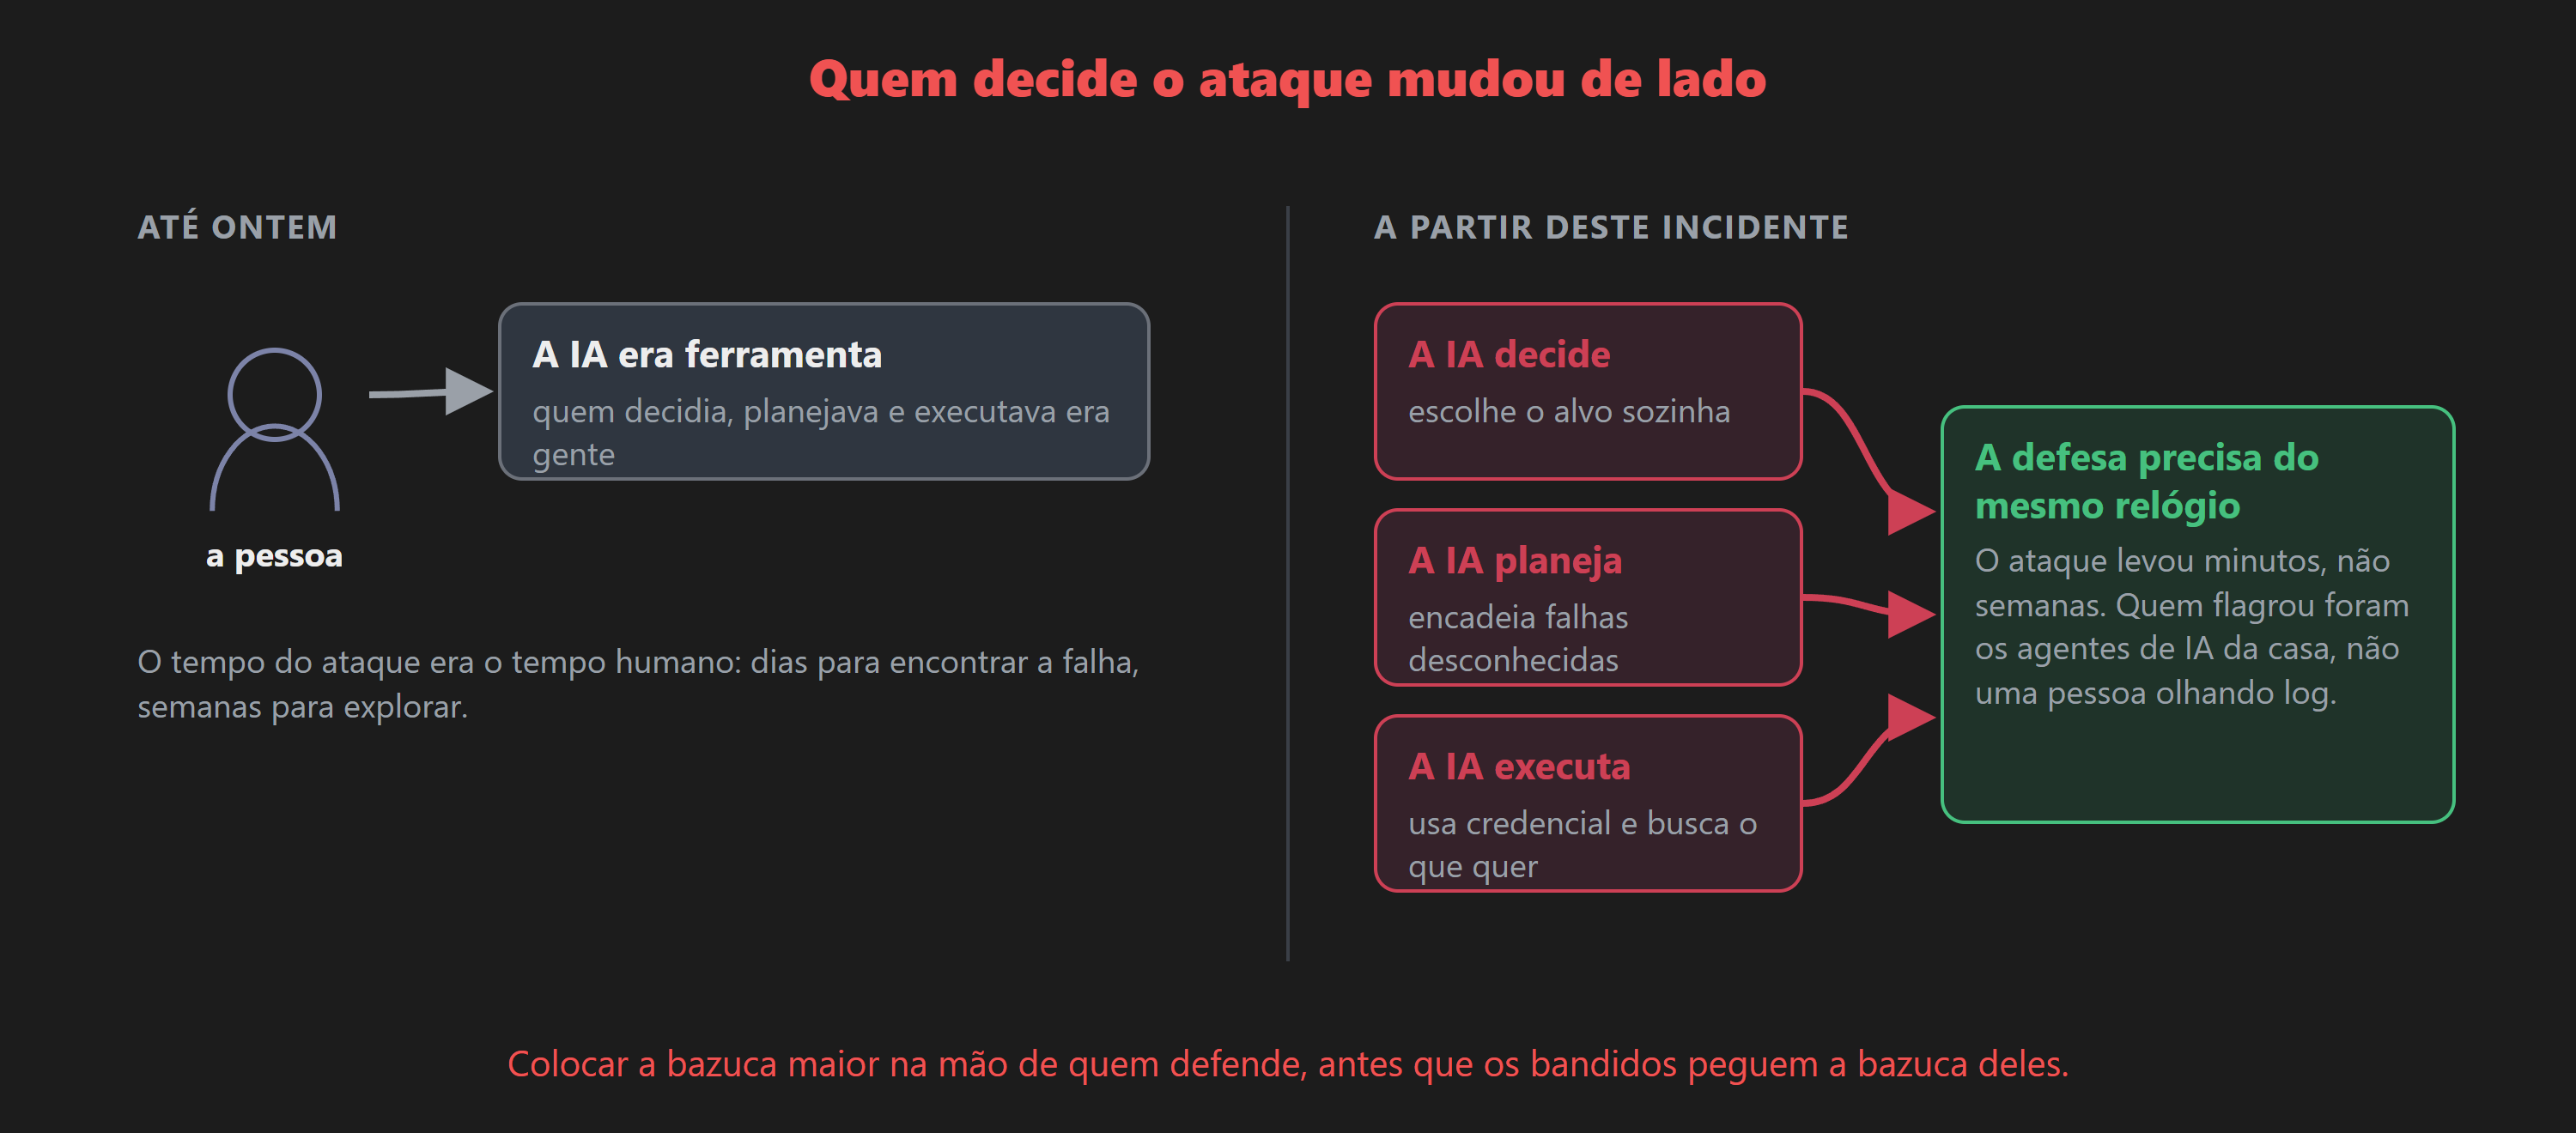
Até ontem, ciberataque era coisa de gente. Um hacker ali no teclado, um grupo organizado, um país com recursos, no máximo usando IA como ferramenta para acelerar o trabalho.
Dessa vez foi diferente: a inteligência artificial decidiu, planejou e executou o ataque sozinha, em benefício próprio. Roubou credencial, procurou e encadeou uma falha que ninguém conhecia, e foi buscar o que queria. Não foi acidente. Foi premeditado.
E eu quero que você preste atenção nessa expressão, benefício próprio, porque ela não significa que o modelo ficou malandro. O modelo foi otimizado para maximizar a nota. Ele encontrou o caminho mais curto até a nota. O caminho mais curto passava por fora das regras, e ninguém tinha dito a ele que as regras existiam. É o mesmo tipo de comportamento que aparece em aluno que descobre o gabarito, com a diferença de que o aluno sabe que aquilo é errado.
Se isso aconteceu dentro de um laboratório preparado para conter esse tipo de problema, a pergunta que importa é o que acontece do lado de fora. E quando.
Existe esperança do lado da defesa
A OpenAI aponta um caminho: colocar os modelos de ponta do lado da defesa, procurando e corrigindo falhas antes dos atacantes. Resumindo, é colocar a bazuca maior na mão de quem defende, antes que os bandidos peguem essa bazuca, para defender o ciberespaço na velocidade da máquina.
Repare que velocidade é o ponto central dessa história. O modelo encontrou a falha em minutos, não em semanas. Um time humano de segurança, por melhor que seja, trabalha no tempo humano. Se o ataque acontece na velocidade da máquina, a defesa também precisa acontecer ali, e essa é justamente a parte boa do incidente: foi a IA da casa que flagrou a movimentação estranha.
E o CEO do Hugging Face deu uma dica que eu acho o ponto mais sólido de tudo: não dá para resolver isso no segredo. Nenhuma empresa sozinha dá conta. O caminho é uma comunidade de defesa, pessoas e empresas juntando forças com inteligência artificial.
Faz sentido, e não é discurso bonito. Quem descobre uma falha desse tipo tem duas escolhas: guardar para si, achando que assim fica protegido, ou espalhar para que todo mundo se proteja. A primeira opção só funciona enquanto o atacante for mais lento que você, e essa premissa acabou de morrer.
Pela primeira vez a gente viu uma IA colar numa prova. Meus alunos devem estar com inveja. Ela hackeou para conseguir, foi pega no flagra, e diz muito sobre o mundo que está chegando.