Retreinei o Laya e ele bateu o Jev no golpe de Pix
Apareceu uma rede neural que roda no seu computador, sem servidor nenhum, e que consegue ser muito mais rápida que o Jev. O nome dela é Laya. Só que ela chegou com fama de errar bastante, e a fama tem fundamento, eu medi.
Então eu fiz o que eu sempre faço quando uma IA não conhece o meu problema: retreinei. Peguei o Laya, ensinei golpe de Pix para ele e botei o bicho para brigar com o Jev de novo, na mesma arena de antes.
A mesma arena, outro adversário
Se você leu o texto do Rust contra o Python, já conhece o detector de golpe em tela dividida: 1.000 mensagens de WhatsApp, 75 golpes plantados no meio delas, e cada lado decidindo sozinho o que é golpe e o que é mensagem normal.
Dessa vez eu mexi em duas coisas. Tirei o DeepSeek e coloquei o Laya no lugar dele, e passei os dois lados para Rust. Assim a linguagem deixa de ser variável e a briga fica só entre os modelos. O Jev continua rodando no servidor da TypeSafe. O Laya roda aqui, na minha máquina.
O plantonista que vê golpe em tudo
Deixa eu te contar o que aconteceu na primeira rodada, com o Laya do jeito que ele vem, sem mexer em nada.
A velocidade impressiona logo de cara. O Jev terminou as 1.000 mensagens em 267,3 segundos e o Laya em 34,3 segundos, quase oito vezes mais rápido. E o motivo é simples: o Laya não sai da máquina. O Jev é rápido, decide na casa dos 200 milissegundos, mas cada mensagem ainda viaja até o servidor e volta. Essa viagem o Laya não faz.
Agora repara no que acontece quando a gente olha a acurácia, que é o que interessa de verdade. Eu sempre bato nessa tecla: fazer rápido e fazer mal não adianta nada. Comparação séria olha velocidade, custo e qualidade juntos.
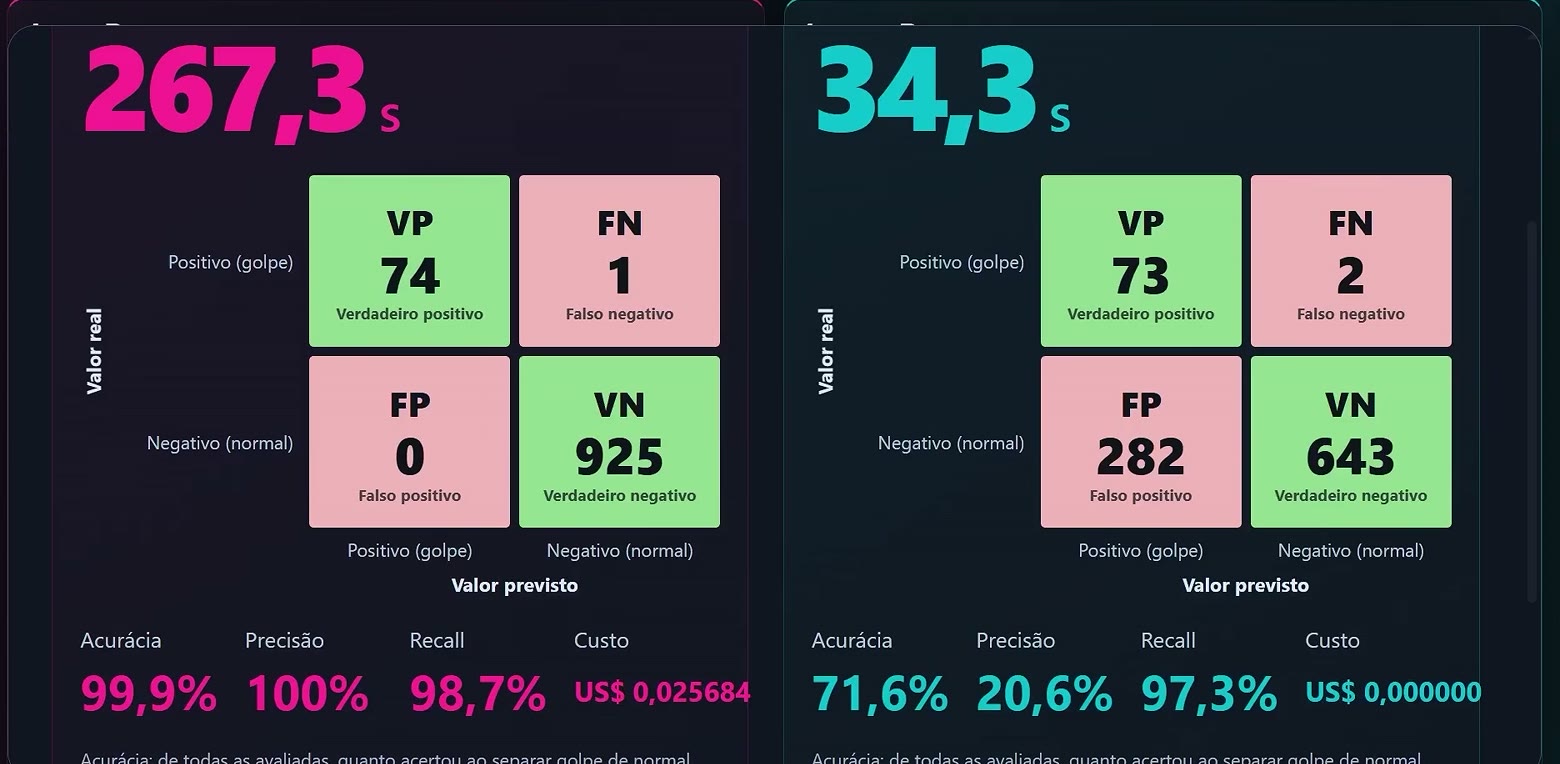
O Laya achou 73 dos 75 golpes, o que é um recall de 97,3%. Parece ótimo, até você olhar a linha de baixo: 282 mensagens honestas marcadas como golpe. Quase um terço das mensagens normais. A precisão despencou para 20,6% e a acurácia ficou em 71,6%.
Pensa num médico recém-formado no primeiro plantão, com medo de deixar passar alguma coisa. Ele não manda ninguém doente para casa, verdade. Só que interna todo mundo que entra pela porta. Esse é o Laya sem treino. E o que resolve esse médico você já sabe, porque eu repito isso no livro inteiro: ele não precisa voltar para a faculdade, ele precisa de residência.
A residência do Laya
A residência aqui é o fine-tuning, e quem conduz é o IT'S FINE, o framework do meu livro. Se você quer a explicação completa do framework e das etapas, está na aula completa de fine-tuning. Aqui eu vou direto ao que aconteceu nessa rodada.
Comecei pelo fine-start, dizendo a intenção em linguagem natural: quero retreinar o Laya para detectar golpe de Pix neste projeto, respondendo às mesmas quatro perguntas que o projeto já manda para o Jev. É golpe? Que tipo de golpe? Tem urgência? Pede Pix? A entrada é a mesma também, remetente e mensagem.
Os dados de treino são outros. São quase 3.000 mensagens sintéticas geradas para esse retreino, mais 554 de validação. As 1.000 mensagens da arena ficaram de fora. O framework congela esse teste: ele não pode ser usado para ajustar nada, só entra na avaliação final. Guarda isso, porque é o que dá valor ao resultado lá no fim.
E antes de treinar, o framework congela também o objetivo. Os critérios de aprovação ficaram definidos antes de qualquer número aparecer: acerto de pelo menos 95%, no máximo 46 alarmes falsos, que é 5% das 925 mensagens honestas, e recall de pelo menos 90%. Nada disso podia mudar depois de ver o teste. Você percebe a diferença? Não é eu olhando o resultado e escolhendo a régua que me favorece.
A GPU emprestada do Google
Para treinar rede neural você precisa de GPU, e muito provavelmente você não tem uma boa em casa. A saída é o Google Colab, que empresta GPU de graça.
O fluxo é bem simples. O IT'S FINE gera um notebook, você sobe ele no Colab, escolhe a GPU T4 e dá play. O notebook te entrega um arquivo, você salva na pasta de downloads, e o framework acha esse arquivo sozinho e fecha a conexão. Ele cria um túnel pela Cloudflare entre a sua máquina e o Colab, manda os dados protegidos, e você acompanha o treino inteiro daqui, no seu terminal. A única regra é não fechar a aba do Colab.
O treino levou 32 minutos: 3 épocas, 558 passos, pico de 6,5 GB de memória na GPU. A receita foi LoRA, que treinou 18,2 milhões de parâmetros, 5,6% da rede. No fim, o que volta para a sua máquina é só o adaptador, 69 MB, com os hashes conferidos.
A perda do treino, o erro que a rede vai diminuindo, caiu de 0,79 para perto de zero. E aqui vai um cuidado que o próprio relatório do framework faz questão de registrar: perda perto de zero, sozinha, não prova nada. Quem mede qualidade é a validação e o teste, com mensagens que o modelo nunca viu.
Na validação, antes e depois do treino, ficou assim:
| Pergunta | Laya sem treino | Laya treinado |
|---|---|---|
| É golpe? | 84,8% | 98,4% |
| Tipo do golpe | 26,4% | 73,7% |
| Urgência | 47,5% | 50,5% |
| Pede Pix? | 64,8% | 95,1% |
A pergunta que importa para o detector, se é golpe ou não, subiu para 98,4%. Pede Pix subiu junto. Tipo melhorou muito, mas ainda erra bastante entre um tipo e outro. E a urgência quase não saiu do lugar, e ainda ficou confiante demais. Não vou esconder isso de você: é aí que mora a próxima rodada de treino, com mais exemplos dessas classes.
A hora da verdade
Com o adaptador de volta na máquina, subi o servidor de novo. De um lado o Jev original, do outro o Laya V2, o residente. As mesmas 1.000 mensagens da primeira rodada, que ele nunca viu no treino.
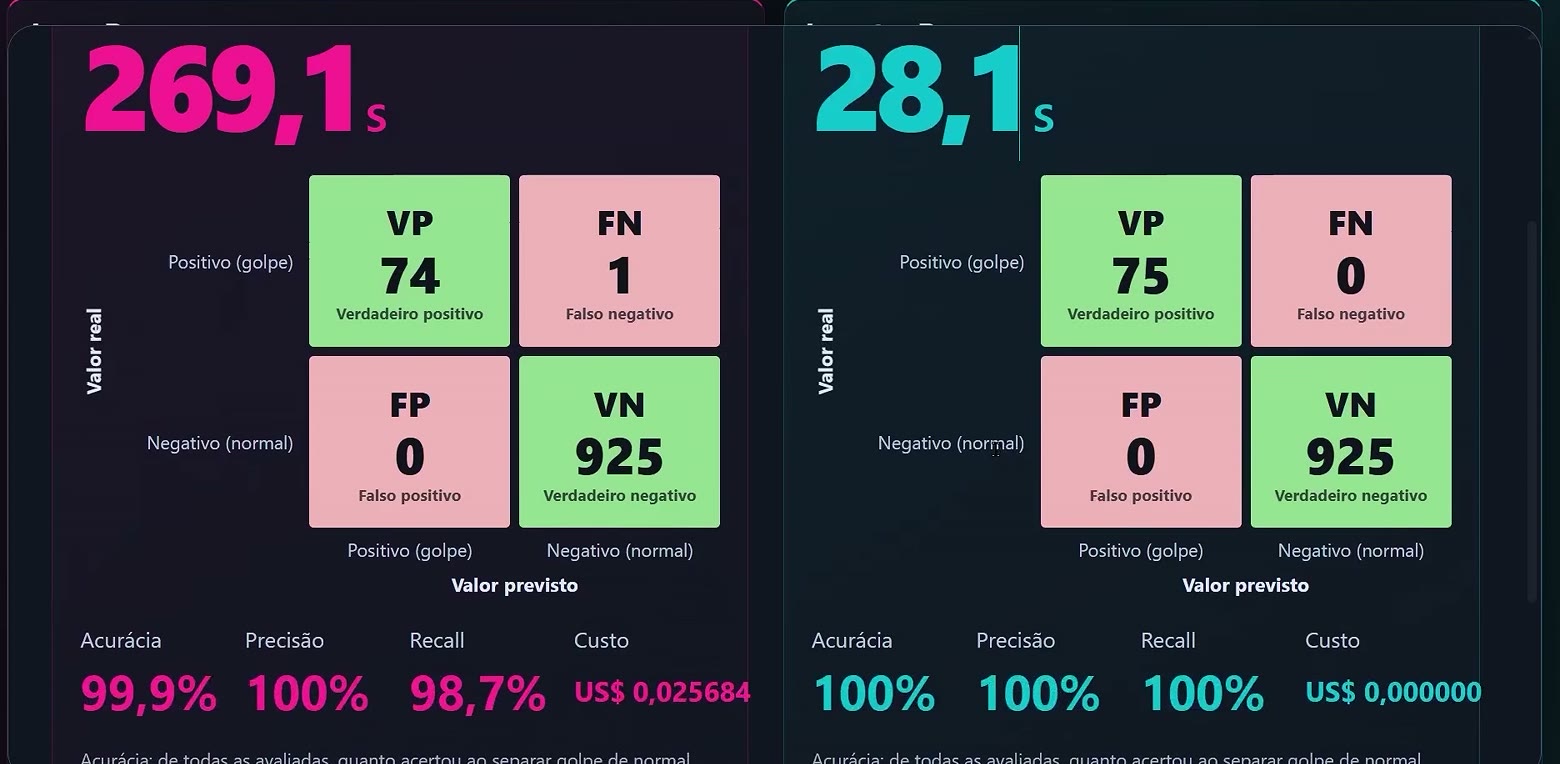
O Jev fez o mesmo papel de sempre: 74 golpes encontrados, 1 deixado passar, nenhum alarme falso, acurácia de 99,9%. É o mesmo resultado que ele tinha feito no texto do Rust contra o Python, o que mostra que ele é consistente.
O Laya V2 pegou os 75 golpes e acertou as 925 mensagens honestas. Zero alarme falso, zero golpe perdido, 100% de acurácia, precisão e recall. Os 282 alarmes falsos sumiram. E ele ainda ficou mais rápido, 28,1 segundos contra 269,1 do Jev, quase dez vezes, com mediana de 23 milissegundos por mensagem.
O custo do Jev nessa rodada foi de US$ 0,025684. O do Laya foi zero, porque roda na minha GPU. Velocidade máxima, acurácia máxima e custo zero, nessa tarefa.
Onde eu seguro a empolgação
Agora deixa eu fazer com o meu número o que eu faria com o número de qualquer outra pessoa.
Cem por cento em 1.000 mensagens é exatamente o tipo de resultado que acende a luz do overfitting, e o relatório do framework aponta esse risco. O teste estava congelado e o modelo não viu essas mensagens, isso conta muito. Mas o treino foi com dado sintético, e é uma rodada só, na minha máquina, numa base que eu mesmo montei. Com mensagem real, de banco de verdade, a conversa pode ser outra. O caminho é retreinar com mais dados, mais variados, e medir de novo.
Ninguém matou ninguém
Cuidado com esse mata-mata que a internet adora. O Laya não matou o Jev.
O que aconteceu é que o Laya virou especialista. Ele ficou muito bom em golpe de Pix, e só nisso. Se você precisa de um modelo que faz uma coisa específica, rodando local, rápido e sem pagar por chamada, o Laya retreinado é show de bola. Se você precisa de um System One que entende uma variedade grande de assuntos sem treino nenhum, o Jev ainda é o caminho, mesmo com a acurácia que o pessoal já anda questionando por aí.
E os dois servem para a mesma coisa: uma intenção em linguagem natural na entrada e uma decisão na saída. Isso tem cheiro forte de robótica. É por isso que eu falei do carro autônomo lendo placa de texto no outro texto, e isso vale tanto para o Jev quanto para o Laya, sabendo que o Laya pede retreino para o seu problema. Eu tenho quase certeza de que esse tipo de modelo veio para ficar.
Na mentoria do livro eu mostro o passo a passo que ficou de fora do vídeo: como criar a conta no Jev, como baixar o Laya para a sua máquina e como fazer esse retreino em detalhes. O IT'S FINE vem com o livro de fine-tuning, e as aulas da mentoria vêm junto, sem pagar nada a mais.